• Comment choisir les commutateurs de centre de données de nouvelle génération pour les charges de travail d'IA et les réseaux hautes performances
    October 26, 2026
    Le commutateur que vous choisissez influe sur l'utilisation optimale des GPU et la rapidité d'exécution des tâches. Dans un centre de données dédié à l'IA, les commutateurs doivent acheminer le trafic entre les nœuds GPU à haut débit et en permanence, avec une latence faible et constante. Un maillon faible ralentit les opérations de groupe et immobilise des ressources de calcul coûteuses.Quels éléments doivent guider votre choix lorsque vous choisissez commutateurs de centre de données de nouvelle génération Pour l'IA et les réseaux haute performance ? Il vous faut une comparaison objective des technologies et une liste de contrôle pratique, pas des affirmations de fournisseurs.Ailink vous présentera en détail les performances, l'adéquation à l'application, la conformité et le coût. Vous repartirez avec des arguments solides à présenter à votre équipe et une feuille de route claire pour prendre une décision éclairée.Points clés à retenirAdaptez le commutateur à votre charge de travail d'IA. Les tâches d'entraînement importantes nécessitent une faible latence et une bande passante élevée.Testez les commutateurs avec du trafic IA réel. Demandez le débit, la latence de queue et le temps d'exécution des tâches.Réglez soigneusement le contrôle de la congestion. Cela peut améliorer les performances jusqu'à 40 %.Vérifiez l'efficacité énergétique. Les baies d'IA consomment beaucoup d'énergie, choisissez donc des commutateurs efficaces.Évaluez le coût total. Incluez l'optique, les licences, l'énergie et les compétences du personnel.Comment l'IA remodèle la demande des commutateursCirculation est-ouest et opérations collectivesLes anciens réseaux d'entreprise acheminent principalement du trafic nord-sud, c'est-à-dire des requêtes utilisateur vers serveur. Les clusters d'IA fonctionnent différemment. Ils génèrent un trafic est-ouest massif qui circule latéralement entre les GPU, les serveurs et le stockage, et ce flux latéral constitue l'essentiel du travail d'entraînement des IA.L'entraînement distribué échange en permanence les gradients, les tenseurs, les paramètres du modèle et synchronise les données. Grâce au parallélisme des données, des tenseurs et du pipeline, chaque GPU peut communiquer simultanément avec plusieurs autres. Ceci génère des schémas gourmands en bande passante, tels que All-Reduce, All-Gather, Broadcast et Reduce-Scatter.AspectQue se passe-t-il dans les clusters d'IA ?Sens de circulationLe trafic est-ouest est le flux principal ; le trafic nord-sud est le second.Forme de circulationQuelques écoulements importants et durables plutôt que de nombreux petits.SensibilitéLes collectifs réagissent fortement à la latence, à la perte de paquets, à la congestion, à la gigue et à la sursouscription.Les opérations collectives sont très sensibles à la latence. Même un léger délai de synchronisation immobilise des GPU coûteux ; une faible latence stable est donc plus importante qu'un débit maximal théorique. Les architectures utilisent des schémas spine-leaf, des conceptions non bloquantes ou à faible sursouscription, et le RDMA pour limiter les pics de latence.Limites des conceptions héritéesLes anciens réseaux à architecture feuille-épine étaient conçus pour un trafic nord-sud caractérisé par de nombreux flux courts et intermittents. Les charges de travail d'IA, quant à elles, génèrent un petit nombre de flux massifs et persistants. Chaque accélérateur échange son état avec tous les autres, et le moindre retard sur un chemin bloque l'ensemble du système.C’est la latence de queue, et non la latence moyenne, qui est l’indicateur clé. Les flux étant synchronisés, le paquet le plus lent détermine la fin de l’opération. Les architectures traditionnelles ne sont pas optimisées pour cela. Les bibliothèques d’entraînement d’IA supposent également une absence totale de perte de paquets. Or, la perte d’un seul paquet peut entraîner la retransmission de grands ensembles de données, voire un redémarrage complet à partir d’un point de contrôle.Les techniques statiques de routage à coût égal et d'envoi aléatoire de paquets ne sont plus suffisamment performantes. Les solutions ponctuelles ne permettent plus d'atteindre les niveaux de performance exigés par les charges de travail d'IA, car ces dernières évoluent plus rapidement que les architectures réseau traditionnelles ne s'adaptent. Le marché s'oriente vers une meilleure efficacité énergétique, une réduction du temps passé au sein du réseau et une télémétrie enrichie. L'Ethernet haute performance, basé sur des standards ouverts, avec des interfaces jusqu'à 800 GbE et des systèmes de refroidissement liquide, illustre les tendances actuelles. Ailink suit ces évolutions en toute impartialité.InfiniBand contre Ultra EthernetPerformance, ajustement, conformité, coûtLes deux technologies peuvent transporter du trafic IA à haut débit. Elles diffèrent cependant dans leur approche. InfiniBand utilise une infrastructure dédiée et sans perte avec calcul intégré au réseau. Ethernet avec RoCE s'appuie sur une base de standards ouverts et éprouvés pour le RDMA. Le tableau ci-dessous compare les caractéristiques techniques d'une plateforme InfiniBand représentative.SpécificationCommutateur InfiniBand NVIDIA MQM9790-NS2R Quantum-2 NDRGénérationNDR 400GPorts64 x 400G (32 connecteurs OSFP)Bande passante agrégée51,2 Tbit/s, non bloquantLatence de commutationSub-microsecondInformatique en réseauSHARP v4RefroidissementLiquide (QM9790) ; air sur QM9700Puissance typique~800–1 200 WConformitéSpécification IBTA v1.5Prix ​​affiché30 000,00 $des options Ethernet comme le Commutateur central Dell Networking série 9700 Les commutateurs compatibles RoCE, comme d'autres, misent sur l'ouverture et la simplicité d'utilisation. Ils utilisent des outils Ethernet standard et s'intègrent aux environnements multi-fournisseurs. Les procédures de conformité diffèrent également : InfiniBand suit la norme IBTA v1.5, tandis qu'Ethernet est conforme aux normes IEEE et RoCE que votre équipe connaît probablement déjà.Le coût ne se limite pas au prix catalogue. Le commutateur NVIDIA est plus cher, et son gestionnaire de sous-réseau ainsi que les outils UFM engendrent des coûts supplémentaires en termes de licences et de compétences. Les commutateurs Ethernet coûtent souvent moins cher par port et permettent de réutiliser les connaissances du personnel existant. La consommation électrique est également un facteur important. Un commutateur Quantum-2 refroidi par air, entièrement équipé, consomme généralement entre 800 et 1 200 watts, selon les optiques et la charge du trafic. Comparez cette valeur à votre budget d'alimentation avant de vous engager.Où chacun trouve sa place le mieuxLes benchmarks révèlent une situation plus nuancée. Lors de l'entraînement MLPerf pour BERT-Large, Ethernet a terminé en 10 886 secondes contre 10 951 secondes pour InfiniBand, soit un léger avantage pour Ethernet. Lors de l'inférence MLPerf pour LLAMA2-70B-99.9, InfiniBand s'est avéré 1,66 % plus rapide. Sur plusieurs tests d'IA générative, les deux technologies ont affiché des performances quasi identiques, avec un écart inférieur à 0,03 %. La vitesse brute ne suffit que rarement à elle seule pour départager les deux solutions.La nature de la charge de travail est déterminante. L'entraînement parallèle synchrone à grande échelle, avec 8 GPU ou plus et des dizaines de milliards de paramètres, tire pleinement parti de la faible latence et de la bande passante élevée d'InfiniBand. FSDP, ZeRO-3 et le parallélisme tensoriel en bénéficient également, car les regroupements fréquents et précis réagissent fortement aux délais. Pour les modèles de 70 milliards d'éléments ou plus avec des tailles de lots globales importantes, la bande passante d'interconnexion devient cruciale.L'Ethernet convient parfaitement à de nombreux autres cas. Le parallélisme de pipeline permet de gérer un trafic d'activation point à point plus faible et tolère la latence. L'entraînement asynchrone ne présente aucune contrainte de synchronisation. Les petites configurations de 2 à 4 GPU s'appuient sur NVLink au sein du nœud. Le service d'inférence n'a quasiment jamais besoin d'InfiniBand, car NVLink gère le trafic intra-nœud et l'Ethernet haut débit assure les liaisons inter-nœuds.InfiniBand est privilégié pour les charges de travail HPC étroitement couplées exigeant une latence inférieure à 5 microsecondes et le calcul en réseau, où l'infrastructure est dédiée à un seul utilisateur et à un seul type de charge de travail. L'Ethernet moderne, avec une architecture adaptée, constitue une alternative crédible pour les environnements mutualisés, les charges de travail mixtes ou les organisations souhaitant s'affranchir de la dépendance vis-à-vis d'un fournisseur.Aucune des deux options n'est mauvaise. Choisissez une infrastructure adaptée à votre charge de travail, aux compétences de votre équipe et à votre budget. Ailink vous aide à évaluer les deux solutions pour vos commutateurs de centre de données nouvelle génération sans privilégier un fournisseur en particulier.Fonctionnalités importantes des commutateurs de nouvelle générationContrôle de la bande passante, de la latence et de la congestionLes débits des ports atteignent désormais 800 GbE, et les ports haute densité 100G, 200G et 400G répondent aux besoins actuels en bande passante des GPU. La vitesse brute n'est que le point de départ. Quatre capacités déterminent si votre infrastructure peut suivre le rythme des accélérateurs.CapacitéCe qu'il faut rechercherPourquoi c'est importantBande passante et densité de portsPorts 100G, 200G, 400G et nouveau 800GRépond aux besoins en bande passante des collectifs de formation distribuéeLatenceLatence stable et faible entre les ports, aucune gigue sous chargeEmpêche les retardataires dans les collectifs synchronesMise en mémoire tamponTampons profonds et partagés dynamiquementAbsorbe les micro-rafales et projette sans gouttesContrôle de la congestionRoCEv2 avec DCQCN, marquage ECN, PFC sous 802.1QbbGarantit un transport RoCE sans perte et un débit constantLe contrôle de la congestion mérite une attention particulière. DCQCN permet aux cartes réseau de réagir aux marquages ​​ECN, et ECN marque les paquets avant qu'un commutateur ne les abandonne. PFC suspend certaines priorités de classe de service (CoS) afin de protéger le trafic RoCE sans perte. OCI a construit un réseau RoCE évolutif jusqu'à des milliers de nœuds et a défini au moins trois profils de contrôle de la congestion pour les charges de travail sensibles à la latence, au débit et mixtes. Le PFC est appliqué unidirectionnellement en périphérie, entre les hôtes et les commutateurs ToR (Top-of-Rack), jamais au niveau des commutateurs Leaf ou Spine, ce qui évite le blocage en tête de file. ECN permet de limiter le recours au PFC, qui n'est utilisé qu'en dernier ressort. Les petits clusters peuvent exécuter RoCE sans configuration PFC ni ECN sur les commutateurs.Sans mesures d'atténuation, la répartition inégale du trafic et la congestion de la liaison montante ont réduit les performances d'entraînement de plus de 30 % lors d'un déploiement. Le hachage sur le QP de destination via une UDF de commutation, combiné à la mise à l'échelle du QP, a permis d'améliorer les performances d'AllReduce jusqu'à 40 %. L'admission pilotée par le récepteur, où la bibliothèque collective et le transport échangent des paquets d'autorisation d'envoi, limite encore davantage le trafic en transit.Évolutivité, programmabilité, télémétrieConsidérez l'évolutivité, la programmabilité et la télémétrie comme des critères de sélection, et non comme des options. Demandez-vous comment l'infrastructure peut s'étendre au-delà de plusieurs milliers de nœuds, si le commutateur expose la télémétrie au niveau du flux et quel niveau de configuration votre équipe doit gérer. La continuité opérationnelle est également essentielle. Les commutateurs Dell basés sur OS10 conservent une interface de ligne de commande familière pour les équipes qui y sont attachées, et le commutateur central Dell Networking série 9700 s'intègre parfaitement aux environnements standardisés sur cet outil.Choisissez les commutateurs de centre de données de nouvelle génération en fonction de ces critères, puis testez-les avec votre propre trafic avant de vous engager.Ce que révèlent les tests en conditions réellesDonnées de référence issues des tissus d'IAAvant de signer, demandez des chiffres concrets : débit, latence de queue et temps d’exécution des tâches, mesurés sur des infrastructures exécutant du trafic IA réel. Ces données figurent rarement dans les fiches techniques. Demandez-les à votre fournisseur et à Ailink.Les résultats publiés sont encourageants pour les deux architectures. Meta a déployé deux clusters d'IA jumeaux, l'un sur InfiniBand et l'autre sur Ethernet Arista, pour son déploiement Llama 3. Meta n'a signalé aucun goulot d'étranglement réseau sur aucune des deux architectures. Meta a également partagé les détails techniques d'un cluster RoCE de 24 000 GPU. Dans ce cas, RoCE et InfiniBand ont été optimisés pour offrir des performances équivalentes, et les modèles les plus volumineux ont été entraînés sur l'architecture RoCE. Lors des tests NCCL, RoCE Ethernet égale InfiniBand en termes de bande passante de communication globale. Les tests en laboratoire de type MLPerf montrent désormais des différences de temps d'exécution de seulement une fraction de pour cent.La latence de queue reste un facteur de différenciation majeur. Le contrôle de flux basé sur le crédit d'InfiniBand élimine les pertes et garantit une stabilité optimale, même dans le pire des cas. Un réseau Ethernet optimisé pour l'IA offre des performances similaires, mais une configuration PFC mal paramétrée peut entraîner un blocage en tête de file ou un interblocage. Le supercalculateur Colossus de xAI a interconnecté 100 000 GPU NVIDIA Hopper via un réseau Ethernet Spectrum-X. Il a atteint un débit de données de 95 % grâce à un contrôle de congestion adapté aux pics d'activité liés à l'entraînement de l'IA. À la même échelle, un réseau Ethernet traditionnel plafonne à environ 60 % de son débit maximal en raison de milliers de collisions de flux.Leçons tirées des clusters déployésLes clusters déjà utilisés permettent de tirer des enseignements sur le choix de l'outil adapté à la tâche. Une équipe dispensant une formation synchrone étroitement intégrée sur le Commutateur InfiniBand NVIDIA MQM9790-NS2R Quantum-2 NDR Bénéficie d'une latence de queue stable et d'une capacité de calcul en réseau. Une équipe qui standardise son infrastructure Ethernet ouverte avec le commutateur central Dell Networking série 9700 profite d'opérations familières et d'une grande flexibilité, quel que soit le fournisseur.Le choix de la puce et de l'équilibrage de charge influe également sur le temps d'exécution des tâches. La puce Broadcom Jericho3-AI a réduit ce temps de plus de 10 % par rapport aux puces concurrentes. L'Arista 7800R4 HyperPort, qui combine 4 x 800 Gbit/s en 3,2 Tbit/s, a quant à lui diminué le temps d'exécution de 44 % par rapport à un équilibrage de charge traditionnel sur des ports distincts. Ces résultats doivent inciter à des tests, et non constituer une conclusion définitive. Lors du choix de commutateurs de centre de données de nouvelle génération, il est recommandé de les tester sur votre propre infrastructure.Comment choisir les commutateurs de centre de données de nouvelle générationÉlaboration de la liste de contrôle d'évaluationUne bonne liste de contrôle permet de transformer une comparaison vague en une décision justifiable. Évaluez chaque candidat selon six critères et pondérez chaque critère en fonction de votre contexte. Le tableau ci-dessous explique pourquoi les installations dédiées à l'IA nécessitent des réponses différentes de celles des salles de conférence traditionnelles.Domaine de critèresCentre de données traditionnelCentre de données IAAdaptation de la charge de travailCharges de travail stables et prévisiblesCharges de travail dynamiques, irrégulières et gourmandes en donnéesdensité de puissance du rack7–10 kW/rack30 kW à plus de 100 kW/rackRefroidissementRefroidissement principalement par airRefroidissement liquide ou hybrideRéseautageEthernet standardInterconnexions à très haut débit et à faible latenceCommencez par évaluer l'adéquation à la charge de travail. Assurez-vous que le commutateur maintient un débit élevé et une faible latence sur de nombreux nœuds GPU, et qu'il gère correctement le trafic est-ouest. Ensuite, testez ses performances en conditions réelles de trafic IA, et non lors de pics de trafic en laboratoire. Enfin, vérifiez la conformité pour chaque région de déploiement : une présence mondiale garantit la cohérence des conceptions de produits et accélère le déploiement.L'efficacité énergétique mérite une attention particulière. Les baies d'IA haute densité consomment désormais entre 30 kW et plus de 100 kW, tandis que le contrôleur NVIDIA GB200 NVL36 consomme environ 66 kW et le NVL72 environ 120 kW. Les modules OSFP 800G modernes offrent un coût par gigabit inférieur d'environ 40 % aux générations précédentes et une économie d'énergie d'environ 50 % grâce à des technologies DSP et de modulation avancées. Il est essentiel d'intégrer la télémétrie comme critère d'évaluation. Un suivi en temps réel de la consommation énergétique et des charges de l'infrastructure permet d'éviter les interruptions de service, et les modèles d'apprentissage automatique peuvent détecter une baisse de la capacité de refroidissement ou une dégradation du signal fibre avant toute panne. Enfin, il convient de prendre en compte le coût total, incluant l'optique, les licences, la consommation d'énergie et les compétences du personnel.Validation avec AilinkUne liste de contrôle permet de réduire le nombre de candidats. Les tests permettent de trancher. Ailink aide votre équipe à valider les commutateurs de centre de données nouvelle génération avec vos propres charges de travail d'IA avant tout engagement. Vous fournissez vos profils de trafic, vos modèles d'utilisation et votre budget énergétique. Ailink élabore le plan de test en conséquence.Le processus suit un cheminement clair. Premièrement, vous définissez les charges de travail essentielles, de l'entraînement synchrone au traitement des résultats d'inférence. Deuxièmement, Ailink effectue des tests de débit, de latence et de temps d'exécution des tâches sur les infrastructures candidates. Troisièmement, vous analysez les données de télémétrie et la consommation électrique sous charge soutenue. Quatrièmement, vous comparez le coût total du déploiement complet.Cette approche vous permet de choisir des commutateurs de centre de données de nouvelle génération en vous basant sur des données concrètes plutôt que sur des arguments marketing. Ainsi, votre équipe peut consulter les chiffres avant de passer commande. Ailink propose toutes les options comparées ici ; nos recommandations restent donc impartiales et les résultats des tests sont éloquents.Cinq critères doivent guider votre choix : l’adéquation à votre charge de travail, la vitesse réelle en cas de forte demande liée à l’IA, la conformité, l’efficacité énergétique et le coût total. En les considérant tous ensemble, aucune fiche technique ne pourra vous convaincre à elle seule.Appliquez la liste de contrôle à chaque candidat. Demandez des données de référence provenant de plateformes exécutant du trafic d'IA réel. Ensuite, travaillez avec Ailink Il est important de tester vos options en fonction de vos propres charges de travail avant de vous engager. Ces données vous permettent de choisir des commutateurs de centre de données de nouvelle génération en toute confiance, et votre équipe comprendra les chiffres qui sous-tendent cette décision.FAQQuel tissu choisir pour une formation synchrone à grande échelle ?InfiniBand est idéal pour les formations étroitement couplées. Son contrôle de flux basé sur les crédits maintient une latence stable, et le calcul en réseau accélère les tâches collectives. L'Ethernet avec RoCE fonctionne également très bien, une fois le contrôle de congestion optimisé. Choisissez la technologie la plus adaptée à votre charge de travail, aux compétences de votre équipe et à votre budget avant de faire votre choix.Dans quelle mesure le contrôle de la congestion change-t-il réellement les résultats ?Cela les modifie considérablement. Un déploiement a perdu plus de 30 % de ses performances d'entraînement en raison d'un trafic irrégulier et d'une congestion de la liaison montante. Le hachage sur la file d'attente de destination avec mise à l'échelle des files d'attente a permis de récupérer jusqu'à 40 % pour AllReduce. Optimisez l'ECN et le PFC avec soin et effectuez des tests avec votre propre trafic, même en cas de pics.Avez-vous besoin de ports 800 GbE aujourd'hui ?Pas toujours. Les ports haute densité 100G, 200G et 400G répondent à la plupart des besoins actuels des GPU. Optez pour le 800 GbE lorsque votre feuille de route l'exige. Les modules OSFP 800G modernes réduisent le coût par gigabit d'environ 40 % et la consommation d'énergie d'environ 50 %, ce qui rend la migration rentable à long terme.Comment comparer équitablement les fournisseurs ?Évaluez chaque candidat selon l'adéquation à la charge de travail, les performances réelles, la conformité, l'efficacité énergétique, la télémétrie et le coût total. Demandez le débit, la latence de queue et le temps d'exécution des tâches sur des infrastructures d'IA en production. Ensuite, laissez Ailink tester la liste restreinte avec vos propres profils de trafic avant de vous engager.Quel rôle joue le pouvoir dans cette décision ?Un point important. Les racks d'IA consomment désormais entre 30 kW et plus de 100 kW, et une carte graphique NVIDIA GB200 NVL72 consomme environ 120 kW. Un commutateur Quantum-2 refroidi par air, à pleine charge, consomme entre 800 et 1 200 watts. Vérifiez dès le départ l'adéquation de ces chiffres avec la puissance et le budget de refroidissement de votre rack.
  • Configuration matérielle requise pour les serveurs d'IA : liste de contrôle pratique pour le GPU, la mémoire, le stockage et le réseau
    October 20, 2026
    Configuration matérielle requise pour les serveurs d'IA : liste de contrôle pratique pour le GPU, la mémoire, le stockage et le réseau La construction d'un serveur d'IA nécessite plus que le simple choix d'un GPU puissant. Un serveur fiable Configuration du serveur d'IA Il est nécessaire d'équilibrer les performances de calcul, la mémoire système, le débit de stockage, la bande passante réseau, l'alimentation électrique et le refroidissement afin de prendre en charge efficacement des charges de travail spécifiques. Que vous déployiez des services d'inférence IA, affiniez des modèles d'apprentissage automatique, entraîniez de grands modèles de langage (LLM) ou construisiez une infrastructure de données IA, il est essentiel de comprendre exigences matérielles des serveurs d'IA est essentiel pour éviter les problèmes de compatibilité, les goulots d'étranglement en termes de performances et les coûts d'acquisition inutiles.Ce guide explique les composants clés d'un serveur d'IA, comment sélectionner le matériel pour différentes charges de travail d'IA et ce qu'il faut vérifier avant d'acheter des composants de serveur. 1. Commencez par définir la charge de travail d'IA avant de choisir le matériel.Le droit matériel serveur d'IA Cela dépend principalement des besoins du système. Différentes charges de travail imposent des exigences différentes en matière de mémoire GPU, de RAM système, de capacité de stockage et de performances réseau.Avant de sélectionner les composants, définissez la charge de travail, les performances attendues, le volume de données et les besoins d'extension futurs. Entraînement des modèles d'IA vs. Inférence d'IAFormation de modèles d'IA Cela implique le traitement de grands ensembles de données et la mise à jour répétée des paramètres du modèle. Cela nécessite généralement une importante capacité de calcul accéléré, une mémoire GPU suffisante, une bande passante mémoire élevée et une transmission efficace des données. Inférence IA Il utilise des modèles entraînés pour générer des prédictions, des classifications ou des réponses. Ses exigences matérielles dépendent de la taille du modèle, de la longueur des entrées et des sorties, du nombre d'utilisateurs simultanés, des objectifs de latence et du débit attendu. Par exemple, un serveur d'inférence prenant en charge un modèle relativement simple peut privilégier la capacité de mémoire GPU et le rapport coût-efficacité. Un environnement d'entraînement distribué peut nécessiter plusieurs accélérateurs et un réseau à haut débit pour coordonner les tâches de calcul entre les serveurs. Réglage fin, RAG et analyse des donnéesLes autres applications d'IA ont des exigences d'infrastructure différentes.Mise au point du modèle : Nécessite une mémoire d'accélération, une mémoire système et un stockage rapide suffisants pour les ensembles de données et les points de contrôle.Génération augmentée par la récupération (RAG) : Peut nécessiter une combinaison de ressources GPU, de capacité CPU, de stockage rapide et de mémoire pour les services de traitement et de récupération de documents.Analyse des données par l'IA : Bénéficie souvent d'un équilibre optimal entre les ressources CPU, mémoire, stockage et réseau pour la préparation et le traitement des données.Formation distribuée à grande échelle : Nécessite une planification minutieuse des interconnexions des accélérateurs, de la topologie du réseau, du débit de stockage et de la synchronisation des charges de travail. Infrastructure d'IA à serveur unique vs. infrastructure d'IA multi-nœudsUne configuration à serveur unique peut simplifier le déploiement et la gestion pour les charges de travail plus modestes. Les projets d'IA de plus grande envergure peuvent nécessiter plusieurs serveurs connectés via un réseau à haut débit. Lors de la planification d'un environnement multi-nœuds, il est essentiel de prendre en compte non seulement les spécifications de chaque serveur, mais aussi la circulation des données entre les nœuds. Un GPU puissant ne peut exploiter pleinement son potentiel s'il doit fréquemment attendre des données ou une synchronisation sur un réseau saturé. 2. Composants matériels principaux d'un serveur d'IAComprendre la fonction de chaque composant aide les acheteurs à créer un ensemble équilibré Configuration du serveur d'IA plutôt que de sélectionner des pièces individuelles en se basant uniquement sur les spécifications principales. GPU et CPU : Construire les fondements de l’informatiqueLes unités de traitement graphique (GPU) et autres accélérateurs d'IA prennent en charge une grande partie des calculs parallèles nécessaires aux charges de travail d'IA modernes. Leur pertinence dépend du modèle, des exigences de précision, de la capacité de mémoire, des logiciels compatibles et des performances attendues. Lors de l'évaluation Composants de serveur GPU, considérer:Capacité de mémoire de l'accélérateur et bande passante de la mémoirePerformances de calcul pour la charge de travail prévueNombre d'accélérateurs pris en charge par la plateformeConnectivité PCIe et emplacements d'extension disponiblesConsommation électrique, refroidissement et dimensions physiquesCompatibilité des logiciels, des pilotes et des frameworksLe processeur reste important pour la préparation des données, l'orchestration, les opérations de stockage et autres tâches qui prennent en charge les charges de travail des accélérateurs.Pour les systèmes multi-GPU, vérifiez que la carte mère, le processeur, le boîtier et l'alimentation sont compatibles avec la configuration prévue. La disponibilité des emplacements physiques ne garantit pas à elle seule le bon fonctionnement de toutes les cartes graphiques, ni la connectivité ni les performances attendues. Mémoire serveur : capacité, bande passante et fiabilitéLa mémoire système stocke les données de fonctionnement, les résultats intermédiaires, les processus d'application et les informations nécessaires aux processeurs et autres composants du système.Pour les environnements d'entreprise, Mémoire serveur DDR5 ECC RDIMM Il est important d'évaluer cette option lorsque la plateforme serveur la prend en charge. La mémoire ECC peut détecter et corriger certains types d'erreurs de mémoire, tandis que les modules DIMM enregistrés sont conçus pour les architectures de mémoire serveur compatibles. Lors de la sélection mémoire du serveur d'IA, considérer:Capacité totale de la RAM du systèmeCanaux de mémoire et débits de données pris en chargeExigences ECC et DIMM enregistréesCompatibilité du processeur et de la carte mèreRègles relatives aux capacités et à la population des modules DIMM pris en chargeBesoins en mémoire pour le prétraitement des données et les charges de travail simultanées Il ne faut pas supposer qu'une fréquence mémoire plus élevée garantit à elle seule de meilleures performances applicatives. Les performances réelles dépendent de la plateforme complète, de la configuration mémoire, de la charge de travail et des conditions d'exploitation prises en charge. Par exemple, un serveur d'IA traitant de grands ensembles de données peut nécessiter une quantité importante de RAM système même lorsque la mémoire GPU est la principale contrainte lors de l'exécution du modèle. Avant de commander DDR5 ECC RDIMM, vérifiez la liste de compatibilité du fabricant du serveur et les configurations de mémoire prises en charge par la plateforme du processeur. SSD NVMe : stockage rapide pour les charges de travail d’IA activesLes performances de stockage peuvent avoir un impact direct sur la vitesse à laquelle un serveur d'IA charge les modèles, accède aux ensembles de données, écrit les points de contrôle et traite les fichiers intermédiaires.SSD NVMe sont couramment utilisées pour les charges de travail d'IA actives car elles offrent un accès à faible latence et un débit élevé lorsqu'elles sont implémentées sur une plateforme compatible. Lors du choix Disques SSD d'entreprise pour serveurs d'IA, évaluer:Capacité et baies de disques disponiblesProtocole NVMe et interface prise en chargePerformances de lecture/écriture séquentielles et aléatoiresIndices d'endurance et charge de travail d'écriture prévueProtection contre les coupures de courant et autres fonctionnalités d'entreprise, le cas échéantGestion thermique et performances soutenuesCompatibilité avec le serveur, le fond de panier et le logiciel de stockageUn SSD rapide peut améliorer la transmission des données, mais les besoins en stockage varient. Une charge de travail accédant de manière répétée à un modèle relativement petit peut avoir des besoins de stockage différents de ceux d'un pipeline traitant en continu de grands ensembles de données. Il est également important de distinguer les spécifications d'interface des performances réelles de l'application. Les résultats concrets dépendent de la profondeur de la file d'attente, des modèles de charge de travail, de l'endurance du disque, des conditions thermiques et de la configuration du système. Disques durs d'entreprise : stockage haute capacité pour les données d'IADisques durs d'entreprise restent utiles pour les grands ensembles de données, les archives historiques, les sauvegardes et autres charges de travail de stockage où la capacité et le coût par téraoctet sont importants. Comparativement aux SSD, les disques durs offrent généralement des performances d'accès aléatoire inférieures. Cependant, ils peuvent convenir aux niveaux de stockage axés sur la capacité lorsque l'application ne requiert pas la latence d'un SSD. Lors de la sélection disques durs d'entreprise, considérer:Capacité de stockage utilisable requiseCapacité de charge du disque et conditions de fonctionnement prévuesCompatibilité de l'interface et du serveurExigences en matière de redondance et de protection des donnéesPolitiques de sauvegarde et de récupérationDensité de puissance, de refroidissement et de stockageUne architecture de stockage hiérarchisée peut combiner des SSD NVMe pour les données fréquemment consultées avec des disques durs de grande capacité pour les informations moins fréquemment consultées. L'équilibre optimal dépend des habitudes d'accès, des exigences de disponibilité et du budget. Contrôleurs HBA et RAID : Gestion de la connectivité du stockageUn adaptateur de bus hôte (HBA) et un contrôleur RAID ont des fonctions différentes, le bon choix dépend donc de l'architecture de stockage.Un HBA Il assure généralement la connectivité entre le système hôte et les périphériques de stockage compatibles. contrôleur RAID peut fournir une fonctionnalité RAID assistée par matériel lorsque le contrôleur et la configuration le prennent en charge. Avant de choisir une manette, vérifiez :Interfaces et protocoles de disques pris en chargeNombre de disques pris en charge et de ports disponiblesCompatibilité avec le fond de panier du serveurNiveaux RAID requis et fonctions de protection des donnéesSystème d'exploitation et assistance aux pilotesIntégration avec l'architecture de stockage prévuePour le stockage défini par logiciel, l'accès direct au disque peut être préférable dans certaines architectures. D'autres déploiements peuvent nécessiter une fonctionnalité RAID basée sur un contrôleur.Le RAID ne doit pas être considéré comme un substitut aux sauvegardes. La protection des données exige une stratégie plus globale qui prenne en compte la redondance, les procédures de récupération et les conséquences d'une panne matérielle ou logicielle. Cartes réseau, commutateurs et émetteurs-récepteurs optiques : connecter l’infrastructure d’IALes performances du réseau deviennent de plus en plus importantes lorsque les charges de travail d'IA déplacent de grands ensembles de données entre les systèmes de stockage, les serveurs et les nœuds de calcul.L'approprié Réseau de centres de données IA La configuration dépend du volume de trafic, du nombre de nœuds, de la topologie, de la prise en charge des protocoles, des exigences de latence et de l'évolutivité future. Les principaux éléments comprennent :Cartes d'interface réseau (NIC) : Connecter les serveurs au réseau.Commutateurs Ethernet : Assurer la connectivité entre les serveurs, les systèmes de stockage et les autres périphériques réseau.Émetteurs-récepteurs optiques : Convertir les signaux électriques et optiques pour des liaisons réseau compatibles.Câbles à fibres optiques : Transporter des signaux optiques entre les interfaces prises en charge.Pour les déploiements de grande envergure, des débits de 100 GbE, 200 GbE, 400 GbE ou 800 GbE peuvent être envisagés en fonction des besoins en charge de travail et de la conception de l'infrastructure. Ces débits ne constituent pas des exigences universelles pour tous les serveurs d'IA. Lors du choix émetteurs-récepteurs optiques à haut débit, vérifiez les spécifications du commutateur et du port NIC, le débit de transmission pris en charge, la portée, le type de fibre, le connecteur, la longueur d'onde et les exigences d'interopérabilité. Une vitesse de liaison plus élevée n'améliore pas automatiquement toutes les applications. Le réseau doit être conçu en fonction des modèles de trafic réels, et le serveur, le commutateur, l'émetteur-récepteur et le câblage doivent fonctionner ensemble de manière compatible. Alimentation et refroidissement : pour des performances soutenuesLes accélérateurs, processeurs, mémoires et dispositifs de stockage hautes performances peuvent engendrer des besoins importants en énergie et en dissipation thermique.Lors de la planification Alimentation et refroidissement du serveur d'IA, évaluer:Besoins en énergie du système totalCapacité et redondance de l'alimentation électriqueCapacité de distribution et de circuit électriqueExigences en matière de flux d'air du châssis et de refroidissement des composantsCapacités de refroidissement des racks et de l'installationLimites de température de fonctionnementComportement de charge de travail soutenue Ne dimensionnez pas une alimentation en additionnant simplement les puissances nominales des composants sans tenir compte des exigences du système et des recommandations du fabricant.De même, une configuration qui s'intègre physiquement dans un châssis de serveur peut ne pas être adaptée thermiquement à un fonctionnement continu. L'alimentation, la circulation d'air et le refroidissement doivent être validés pour la configuration complète. 3. Configuration du serveur d'IA par charge de travailIl n'existe pas de configuration matérielle unique convenant à tous les projets d'IA. Le tableau suivant récapitule les priorités typiques pour différents scénarios de déploiement.charge de travail IAPriorités matérielles principalesConsidérations importantesInférence IAGPU ou accélérateur, mémoire GPU, RAM système, stockage du modèleTaille du modèle, concurrence, latence, débitMise au point du modèleMémoire GPU, capacité de calcul, RAM système, SSD NVMeTaille de l'ensemble de données, points de contrôle, méthode d'entraînementFormation distribuée en IAAccélérateurs multiples, réseau à haut débit, stockage rapideTopologie d'interconnexion, synchronisation, évolutivitéApplications RAGProcesseur, carte graphique si nécessaire, mémoire vive, stockage SSD, réseauVolume de documents, architecture de recherche, latence de réponsetraitement des données par IAprocesseur, mémoire système, débit de stockageTransformation des données, taille des lots, traitement parallèleensembles de données et archives d'IADisques SSD et HDD d'entreprise, contrôleurs de stockage le cas échéantCapacité, fréquence d'accès, redondance, rétentionIl s'agit de lignes directrices de planification et non de listes de composants fixes. Les exigences réelles varient en fonction de l'architecture du modèle, du cadre de travail, de la pile logicielle, du volume de données, de l'objectif de performance et de l'environnement de déploiement. Par exemple, un service d'inférence d'IA soumis à des exigences strictes de latence peut privilégier la mémoire de l'accélérateur et un accès aux données à faible latence. Un cluster d'entraînement distribué peut quant à lui privilégier les interconnexions de l'accélérateur et le débit du réseau. Un point de départ utile consiste à documenter la charge de travail prévue et les objectifs de performance avant de comparer les différents produits. 4. Comment équilibrer le GPU, la mémoire, le stockage et le réseauLe choix des composants appropriés ne représente qu'une partie du processus. Un système bien conçu configuration matérielle du serveur d'IA Il faut également éviter les goulots d'étranglement entre ces composants. Identifier les goulots d'étranglement en matière de calcul et de mémoireCommencez par évaluer si le modèle et la charge de travail prévus tiennent dans la mémoire de l'accélérateur disponible et si la RAM du système est suffisante pour le prétraitement et les services de support.Si le modèle ou la charge de travail dépasse les ressources disponibles, la solution peut impliquer une modification de la configuration matérielle, l'optimisation du modèle, l'ajustement de la charge de travail ou la répartition du traitement sur plusieurs appareils.L'achat d'une carte graphique plus puissante ne résout pas à lui seul toutes les limitations liées à la mémoire ou à la gestion des données. Adapter les performances de stockage aux modèles d'accès aux donnéesDéterminez si la charge de travail nécessite principalement un débit séquentiel élevé, des lectures aléatoires fréquentes, des écritures soutenues ou un stockage de grande capacité.Pour les ensembles de données actifs et les fichiers de modèles fréquemment consultés, Stockage SSD NVMe peut convenir. Pour les archives volumineuses et les ensembles de données moins fréquemment consultés, stockage disque dur d'entreprise peut offrir un niveau de capacité plus économique.Mesurez les exigences de l'application plutôt que de supposer que chaque serveur d'IA nécessite la même configuration de stockage. Déterminer quand un réseau à haut débit est nécessaireLes exigences en matière de réseau dépendent du volume de données qui transitent entre les serveurs et de la fréquence à laquelle les charges de travail distribuées échangent des informations.Pour l'entraînement multi-nœuds, le débit et la latence du réseau peuvent affecter l'efficacité globale. Pour un serveur d'inférence autonome, une configuration réseau plus simple peut suffire.Lors de l'évaluation Réseaux 400GbE et 800GbE, tenez compte du trafic prévu, de la capacité du commutateur, de la prise en charge des points de terminaison, de la compatibilité des émetteurs-récepteurs et du coût de la mise à niveau de l'infrastructure globale.L'objectif est de supprimer les véritables goulots d'étranglement sans acheter de capacité réseau que la charge de travail ne peut pas utiliser efficacement. Planification de l'évolutivité et du coût total de possessionUn rapport coût-efficacité Configuration du serveur d'IA équilibre le coût d'achat initial avec les dépenses d'exploitation et l'expansion future.Prenez en compte le coût total de possession (CTP), notamment :Acquisition et remplacement de matérielÉlectricité et refroidissementEntretien et garantieExtension du stockage et protection des donnéesmises à niveau du réseauExigences logicielles et opérationnellesCoûts de déploiement et de migration futureUn composant moins cher peut s'avérer un mauvais choix s'il engendre des problèmes de compatibilité ou nécessite une refonte coûteuse ultérieurement. Inversement, des spécifications haut de gamme peuvent ne pas se justifier si la charge de travail n'en tire aucun avantage. 5. Liste de vérification de la compatibilité matérielle du serveur d'IAAvant d'acheter Composants du serveur d'IAVérifiez la compatibilité sur l'ensemble du système. La liste de contrôle suivante peut aider les équipes d'approvisionnement et d'ingénierie à réduire les risques de configuration évitables. Compatibilité GPU et plateformeVérifiez la compatibilité GPU avec le modèle de serveur et la carte mère.Vérifiez les dimensions physiques, l'espacement des emplacements et les ressources PCIe disponibles.Vérifiez les connecteurs d'alimentation, les limites de puissance et les exigences de refroidissement.Confirmer le soutien apporté au nombre d'accélérateurs prévu.Vérifiez les exigences relatives aux micrologiciels, pilotes et logiciels. Compatibilité de la mémoire du serveurVérifiez si la plateforme nécessite de la mémoire ECC RDIMM, un autre type de mémoire pris en charge ou une configuration DIMM spécifique.Vérifiez la capacité de mémoire et les débits de données pris en charge par le processeur.Respectez les règles du fabricant concernant la configuration de la mémoire.Vérifiez les références des modules par rapport à la liste de compatibilité.Veuillez confirmer que les capacités de mélange ou les spécifications des modules sont prises en charge, le cas échéant. Compatibilité du stockage et du contrôleurVérifiez l'interface du disque, le protocole, le format et la capacité prise en charge.Vérifiez le fond de panier du serveur et les baies de disques disponibles.Vérifiez la compatibilité du contrôleur HBA ou RAID le cas échéant.Vérifiez les exigences relatives au système d'exploitation, au micrologiciel et aux pilotes.Définir les exigences en matière de redondance, de sauvegarde et de récupération. Compatibilité réseau et optiqueVérifiez les vitesses prises en charge par la carte réseau et les ports du commutateur.Vérifiez le format et les spécifications d'interface de l'émetteur-récepteur.Vérifiez le type de fibre, le connecteur, la longueur d'onde et la distance de transmission.Vérifiez les exigences de compatibilité du commutateur et de la carte réseau prévus.Évaluer la topologie et la capacité du réseau en vue d'une expansion future. Alimentation, refroidissement et déploiementValider la demande totale en énergie du système et la capacité d'alimentation.Vérifier le flux d'air et les limites thermiques du châssis.Vérifier l'espace disponible dans les racks, la distribution électrique et le système de refroidissement des installations.Examiner les procédures de garantie, de réparation et de remplacement.Tester la configuration complète avant un déploiement à grande échelle.Les spécifications individuelles d'un composant ne garantissent pas sa compatibilité avec l'ensemble du système. En cas de doute, consultez la documentation du fabricant du serveur et obtenez une confirmation technique avant de passer commande. 6. Comment élaborer un plan d'acquisition pratique pour un serveur d'IAUn processus d'approvisionnement structuré permet de garantir que le matériel sélectionné répond aux besoins opérationnels réels.Étape 1 : Définir les exigences de performance et de capacitéDocumentez la charge de travail de l'IA, la taille du modèle, le volume de l'ensemble de données, le débit attendu, les objectifs de latence, la concurrence et la croissance anticipée.Ces exigences constituent la base de l'évaluation des besoins en processeur, processeur graphique, mémoire, stockage et réseau. Étape 2 : Confirmer les références exactes des piècesUtilisez les références exactes du fabricant lors de la comparaison. modules de mémoire serveur, SSD, HDD, contrôleurs, cartes réseau, commutateurs et émetteurs-récepteurs optiques.Les noms de produits et les spécifications principales ne permettent pas à eux seuls d'identifier les différences importantes en matière d'interface, de micrologiciel, de format ou de compatibilité. Étape 3 : Valider la configuration complèteVérifiez la nomenclature complète par rapport à la plateforme serveur, à l'environnement d'exploitation et au déploiement prévu.Pour les projets de grande envergure, il est conseillé de valider une configuration de test avant de procéder à des achats en grande quantité. Cela permet d'identifier les problèmes d'interopérabilité, de performance, de dissipation thermique ou de déploiement avant qu'ils n'affectent l'ensemble du projet. Étape 4 : Évaluer les exigences en matière d’approvisionnement, de garantie et de cycle de viePour l'approvisionnement en matériel B2B, tenez compte de la disponibilité des produits, des délais de livraison, des conditions de garantie, des options de remplacement et du cycle de vie.Pour les déploiements multisites ou par phases, la cohérence des références et la continuité de l'approvisionnement peuvent être particulièrement importantes. Étape 5 : Comparer le coût total et l’expansion futureComparez les configurations en fonction de leur capacité à répondre aux exigences de performance, et non pas simplement en fonction du prix initial de leurs composants.Une évaluation utile doit prendre en compte les coûts d'exploitation, les possibilités de mise à niveau, les besoins en matière de support et les dépenses potentielles liées au remplacement des composants incompatibles. 7. Erreurs courantes lors de la planification du matériel serveur d'IAPlusieurs erreurs récurrentes peuvent compromettre une conception d'infrastructure par ailleurs prometteuse.Choisir les GPU avant de définir la charge de travail : Le choix de l'accélérateur doit tenir compte des exigences du modèle, des objectifs de performance et des contraintes de déploiement.Sous-estimation de la mémoire système : La mémoire du GPU et la RAM système ont des fonctions différentes. Une capacité suffisante est nécessaire pour l'environnement complet de traitement des logiciels et des données.Ignorer les goulots d'étranglement du stockage : Une transmission de données lente ou une architecture de stockage inadaptée peuvent réduire l'efficacité des applications même lorsque les ressources informatiques sont disponibles.Négliger la compatibilité réseau : Les cartes réseau, les commutateurs, les émetteurs-récepteurs optiques et les câbles doivent prendre en charge les interfaces, les vitesses et les conditions de transmission prévues.Mélange de composants incompatibles : Des modules de mémoire, des disques et des produits réseau d'apparence similaire peuvent avoir des exigences de compatibilité différentes.Négliger l'alimentation électrique et le refroidissement : Les charges de travail soutenues peuvent révéler des limitations thermiques et énergétiques qui ne sont pas apparentes à partir d'une simple liste de composants.Considérer la redondance comme une stratégie de sauvegarde complète : Le RAID et autres mécanismes de redondance ne dispensent pas de la mise en place de procédures de sauvegarde et de restauration appropriées.Achat sans validation de la configuration : La compatibilité système complète et la validation de la charge de travail sont plus fiables que les hypothèses basées sur les spécifications individuelles des produits.Pour éviter ces erreurs, une coordination est nécessaire entre les services d'ingénierie, d'approvisionnement, d'exploitation informatique et les fournisseurs de matériel. 8. Foire aux questions sur le matériel serveur d'IAQuel matériel est nécessaire pour construire un serveur d'IA ?Un type Serveur IA Elle comprend un processeur, de la mémoire système, un ou plusieurs GPU ou autres accélérateurs d'IA selon les besoins, des périphériques de stockage, des interfaces réseau, une carte mère et un châssis compatibles, des alimentations et un système de refroidissement. La configuration exacte dépend du modèle, de la charge de travail, des objectifs de performance et de l'échelle de déploiement. De combien de RAM un serveur d'IA a-t-il besoin ?Les exigences Capacité de RAM du serveur d'IA Cela dépend du système d'exploitation, du logiciel de rendu, du prétraitement des données, des applications simultanées et de la charge de travail. La mémoire GPU et la RAM système sont des ressources distinctes ; il est donc nécessaire de les évaluer toutes deux. Vérifiez les limites de la plateforme et les exigences de l'application avant de déterminer la capacité requise. Les SSD NVMe sont-ils nécessaires pour les serveurs d'IA ?SSD NVMe Les disques NVMe sont utiles lorsque les charges de travail tirent parti d'un stockage à faible latence et d'un débit élevé, comme le chargement de modèles, l'accès aux jeux de données actifs et l'écriture de points de contrôle. Cependant, tous les serveurs d'IA n'ont pas besoin d'un stockage NVMe pour chaque niveau de données. Le choix du stockage doit tenir compte des modèles d'accès, des besoins en capacité et du budget. Les serveurs d'IA ont-ils besoin d'un réseau 400G ou 800G ?Non. Réseaux 400GbE et 800GbE Ces configurations peuvent convenir à certains clusters d'IA à large bande passante, mais ne constituent pas des exigences universelles. Le débit du réseau doit être choisi en fonction des modèles de trafic, du nombre de nœuds, des exigences de l'application, de la compatibilité des terminaux et de l'architecture réseau globale. Comment vérifier la compatibilité matérielle d'un serveur d'IA ?Commencez par consulter la documentation du fabricant du serveur et la liste des composants compatibles. Vérifiez les références exactes, les spécifications de la mémoire, les interfaces des disques, les exigences PCIe, la compatibilité des cartes réseau et des émetteurs-récepteurs, les limites de puissance et les contraintes de refroidissement. Validez la configuration complète avant tout achat en grande quantité. Dois-je opter pour des SSD ou des disques durs d'entreprise pour le stockage des données IA ?Choisir SSD d'entreprise lorsque la faible latence, les IOPS élevées ou l'accès rapide aux données sont importants. Considérez disques durs d'entreprise Pour les ensembles de données volumineux, les archives et autres charges de travail tolérant une latence d'accès plus élevée, une architecture hiérarchisée combinant les deux types de stockage est souvent préférable. Quels sont les éléments à prendre en compte lors de l'achat en gros de composants de serveurs d'IA ?Vérifiez scrupuleusement les références exactes, la compatibilité, la quantité, la disponibilité, les délais de livraison, les conditions de garantie, le cycle de vie et la cohérence de la commande. Pour les projets complexes, demandez une nomenclature vérifiée et validez une configuration d'essai avant de procéder à un achat en grande quantité. Conclusion : Concevoir un serveur d’IA adapté à la charge de travailRéussi planification matérielle des serveurs d'IA Tout commence par la charge de travail, et non par les spécifications d'un produit en particulier. Les ressources GPU et CPU, la mémoire du serveur, le stockage, le réseau, l'alimentation électrique et le refroidissement doivent fonctionner de concert pour répondre aux exigences du projet en matière de performances, de fiabilité et de budget.Une structure Liste de contrôle du matériel pour serveur d'IA Elle aide les équipes à identifier les risques de compatibilité, à éviter les dépenses inutiles et à planifier leur croissance future. En validant la configuration complète avant l'achat, les entreprises peuvent prendre des décisions plus éclairées concernant leur infrastructure d'IA.Pour les entreprises à la recherche de composants informatiques et réseau, AILINK100 peut servir de point de départ pour explorer les catégories de matériel et les options de produits pertinentes. Avant de demander un devis, préparez le modèle de votre serveur, la charge de travail prévue, les spécifications requises, les quantités estimées et les exigences de livraison. Besoin d'aide pour trouver du matériel serveur ? Contactez l'équipe AILINK100 pour discuter de vos besoins en composants et identifier les produits adaptés pour un examen de compatibilité plus approfondi et une planification des achats.
  • Pourquoi la mémoire DDR5-5600 ECC RDIMM est-elle idéale pour les serveurs d'entreprise ?
    Pourquoi la mémoire DDR5-5600 ECC RDIMM est-elle idéale pour les serveurs d'entreprise ?
    September 28, 2026
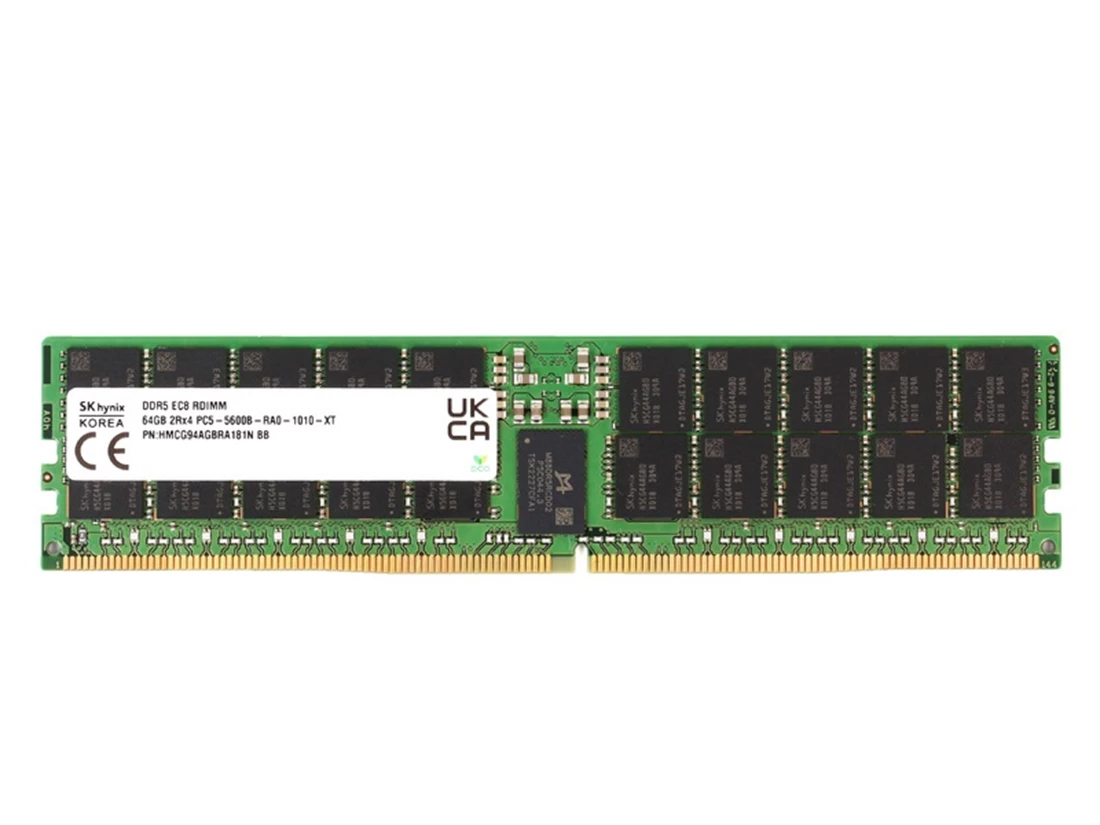
    Les serveurs d'entreprise exigent une mémoire alliant vitesse, fiabilité et évolutivité. La barrette DDR5-5600 ECC RDIMM offre cette combinaison idéale. Elle garantit des performances élevées à 5 600 MHz (PC5-44800) pour les charges de travail les plus exigeantes. La correction d'erreurs ECC intégrée assure une protection optimale des données critiques. Sa conception enregistrée préserve l'intégrité du signal sur plusieurs modules. Cette barrette DDR5 ECC RDIMM enregistrée excelle dans la virtualisation, les bases de données et le calcul haute performance (HPC). En tant que mémoire serveur de qualité professionnelle, elle élimine les goulots d'étranglement. L'architecture DDR5 ECC RDIMM enregistrée prend en charge les fortes densités de mémoire. Cette barrette DDR5-5600 MHz ECC RDIMM enregistrée constitue une solution de mémoire serveur d'entreprise fiable. Mémoire SK hynix DDR5-5600 Elle représente une solution complète. Vous bénéficiez de fiabilité, de performances et d'une évolutivité optimales avec une seule barrette DDR5 RDIMM. Cette mémoire pour serveurs d'entreprise garantit un fonctionnement fluide de l'infrastructure.Points clés à retenirLa correction d'erreurs ECC corrige automatiquement les erreurs de mémoire à un bit. Cela évite les plantages système et protège vos données.La conception brevetée réduit la charge sur le contrôleur de mémoire. Votre serveur prend en charge davantage de modules de mémoire avec des signaux stables.La mémoire DDR5-5600 offre une vitesse rapide de 5 600 MHz tout en consommant seulement 1,1 V. Vous bénéficiez ainsi de hautes performances et d'économies d'énergie.Cette mémoire est compatible avec les serveurs Intel Xeon et AMD EPYC. Veuillez toujours vérifier la liste des composants compatibles (QVL) de votre serveur pour une compatibilité totale.Des capteurs thermiques intégrés gèrent la chaleur et ajustent la fréquence de rafraîchissement. Votre serveur reste stable même en cas de forte charge de travail.Rôle des modules RDIMM ECC DDR5-5600 dans la fiabilité des serveursCapacités de correction d'erreurs ECCLa mémoire DDR5-5600 ECC RDIMM assure une correction active des erreurs pour les serveurs d'entreprise. Le code ECC (Error-Correcting Code) intégré à ce module corrige automatiquement les erreurs de mémoire d'un seul bit. Cette correction prévient les pannes système inattendues et la corruption des données dans les applications critiques. Cette protection est essentielle pour les charges de travail telles que les transactions de bases de données ou le traitement financier. Un seul bit corrompu peut entraîner des interruptions de service coûteuses. La mémoire ECC élimine ce risque en corrigeant les erreurs avant qu'elles n'affectent les opérations.Les modules DIMM ECC standard implémentent la technologie SECDED (correction d'erreur simple, détection d'erreur double), qui corrige toute erreur sur un seul bit et détecte, mais ne peut pas corriger, les erreurs sur deux bits.Pour les environnements d'entreprise, la prise en charge complète de la correction d'erreurs (ECC) garantit une protection optimale. Le module détecte et corrige la plupart des erreurs de mémoire de manière silencieuse, préservant ainsi l'intégrité des données sans intervention manuelle. Vous pouvez faire confiance à votre mémoire DDR5 ECC pour gérer les erreurs susceptibles de corrompre les données ou d'interrompre les services. La mémoire SK hynix DDR5-5600 intègre cette technologie ECC avancée. Module RDIMM DDR5 ECC enregistré, elle offre une protection supérieure contre les erreurs et une fiabilité éprouvée pour vos applications les plus exigeantes.Modèle déposé pour l'intégrité du signalOutre la correction d'erreurs, la conception enregistrée de cette barrette DDR5 ECC Registered RDIMM améliore l'intégrité du signal. Lorsqu'un serveur est équipé de nombreux modules de mémoire, la charge électrique augmente. L'architecture RDIMM réduit cette charge sur le contrôleur de mémoire. Cette conception garantit un fonctionnement stable, même dans les configurations à haute capacité.Le contrôleur de mémoire de votre serveur envoie des signaux de commande et d'adresse aux modules de mémoire.Sur une barrette DDR5 RDIMM, un registre interne (Registered Clock Driver, RCD) reçoit ces signaux en premier. Ces signaux ne sont pas directement acheminés vers chaque puce DRAM.Le registre met en mémoire tampon les signaux de commande et d'adresse, puis les retransmet aux dispositifs DRAM.Étant donné que le contrôleur de mémoire ne gère que l'entrée du registre au lieu de la totalité de la charge DRAM, la charge électrique directe sur le contrôleur est considérablement réduite.Cette réduction de la charge améliore l'intégrité du signal et permet à votre système de prendre en charge davantage de modules de mémoire par canal et une capacité totale plus élevée. Le RCD améliore également l'intégrité du signal à haute fréquence. En DDR5, le RCD génère quatre signaux d'horloge par côté au lieu de deux. Chaque groupe de puces DRAM reçoit son propre signal d'horloge indépendant. Cette conception réduit le bruit et améliore la fiabilité à 5 600 MT/s. Cette technologie DDR5 RCD offre un débit de données supérieur de 17 % à celui de la génération précédente. Vous bénéficiez ainsi d'une latence et d'une consommation réduites, ainsi que de paramètres de synchronisation optimisés pour des marges de module accrues.FonctionnalitéDDR4DDR5Fréquences d'horloge de sortie par côté24Signaux d'horloge indépendantsNoOuiAmélioration de l'intégrité du signalLimitéAmélioréLe RCD joue le rôle de puce de plan de contrôle essentielle, distribuant les signaux de commande/adresse et d'horloge aux dispositifs DRAM. Votre serveur bénéficie ainsi d'une intégrité de signal supérieure pour les signaux de commande/adresse et d'horloge. Cette conception RDIMM ECC enregistrée garantit un fonctionnement fiable de la mémoire ECC de votre serveur, même sous fortes charges. En tant que module RDIMM DDR5 ECC enregistré, cette mémoire offre la stabilité nécessaire aux applications d'entreprise. Ces modules de mémoire ECC offrent des performances constantes dans les environnements exigeants. Vous pouvez compter sur elle. mémoire ecc rdim pour une performance à long terme. Gains de performances avec la mémoire RDIMM enregistrée ECC DDR5-5600 MHz Augmentation de la bande passante pour les charges de travail d'entrepriseLa mémoire RDIMM ECC DDR5-5600 offre un débit de données de 5 600 MT/s, également appelé PC5-44800. Cette haute performance à 5 600 MHz (PC5-44800) élimine les goulots d'étranglement dans les charges de travail exigeantes des entreprises. Vous bénéficiez ainsi de requêtes de base de données plus rapides, d'opérations de cloud computing plus fluides et de résultats d'inférence IA plus rapides. Le module RDIMM ECC DDR5 gère des transferts de données massifs sans ralentir vos applications critiques. Ce module de mémoire serveur DDR5 ECC enregistré offre une bande passante de 5 600 MHz (PC5-44800) qui optimise les performances de votre serveur. Dans les environnements de virtualisation, chaque machine virtuelle partage les ressources mémoire. Le module RDIMM DDR5-5600 MHz ECC enregistré fournit une bande passante suffisante pour garantir le bon fonctionnement de toutes les machines virtuelles. Votre hyperviseur conserve ainsi sa stabilité, même en cas de forte charge. Les charges de travail de calcul haute performance (HPC) tirent un profit considérable de cette bande passante. Les simulations scientifiques, la modélisation financière et le séquençage génomique exigent tous un transfert de données rapide. La mémoire serveur DDR5 ECC garantit que vos processeurs ne soient jamais en attente de données. Les systèmes de stockage bénéficient également de cette vitesse. Vous obtenez ainsi des opérations de lecture et d'écriture plus rapides sur l'ensemble de votre infrastructure. La mémoire DDR5 RDIMM fonctionne avec une latence CAS CL46. Cette spécification de synchronisation offre un équilibre optimal entre vitesse et réactivité pour les applications d'entreprise. La mémoire SK hynix DDR5-5600 apporte ces gains de performance à votre centre de données. Vous pouvez déployer cette mémoire en toute confiance dans les serveurs de bases de données, les plateformes cloud et les infrastructures d'IA. Fonctionnement à faible consommation à 1,1 VL'efficacité énergétique est cruciale dans les centres de données d'entreprise. La mémoire DDR5-5600 MHz ECC Registered RDIMM fonctionne à seulement 1,1 V. Cette faible tension réduit considérablement la dissipation thermique. Vos systèmes de refroidissement sont moins sollicités et vos coûts énergétiques diminuent. Vous optimisez ainsi votre consommation d'énergie. La densité de 64 Go avec une configuration 2Rx4 permet une évolutivité économique. Vous équipez vos serveurs de moins de modules tout en atteignant une capacité totale supérieure. Ce module de mémoire serveur haute capacité réduit l'encombrement et simplifie la maintenance. Chaque RDIMM offre une capacité de mémoire importante sans occuper un espace excessif.ParamètreSpécificationDébit de données5600 MT/s (PC5-44800)Tension de fonctionnement1,1 VDensité64 GoConfiguration des rangs2Rx4Latence CASCL46La conception RDIMM à registre ECC contribue également aux économies d'énergie. Le registre met en mémoire tampon les signaux de commande et d'adresse, réduisant ainsi la charge électrique sur le contrôleur de mémoire. Votre système consomme moins d'énergie tout en préservant l'intégrité du signal. Cette architecture RDIMM à registre ECC s'avère essentielle pour les déploiements de modules de mémoire serveur haute capacité. Les environnements de virtualisation, les clusters HPC et les systèmes de stockage tirent tous profit de cette combinaison. Vous bénéficiez des performances de la technologie DDR5 et de la fiabilité de la protection ECC. Le module RDIMM DDR5 ECC enregistré prend en charge vos charges de travail les plus exigeantes. Votre centre de données fonctionne efficacement tout en offrant un débit maximal. Comment la mémoire ECC RDIMM valide l'intégrité des donnéesValidation rigoureuse de niveau entrepriseLes serveurs d'entreprise fonctionnent en continu, votre mémoire ECC RDIMM doit donc résister à un fonctionnement intensif. La mémoire SK hynix DDR5-5600 est soumise à des tests de résistance de niveau serveur simulant les conditions réelles d'un centre de données. Ces tests soumettent les modules à des cycles de rodage prolongés, à des températures extrêmes et à un trafic de données soutenu. L'objectif est simple : prouver que chaque module DDR5 ECC RDIMM enregistré peut gérer des charges de travail 24 h/24 et 7 j/7 sans défaillance. La conformité JEDEC constitue le fondement de cette validation. La norme JEDEC DDR5 RDIMM définit les exigences électriques et mécaniques des modules DIMM DDR5 1,1 V à 288 positions. Toutefois, la conformité JEDEC à elle seule ne garantit pas la compatibilité universelle avec les serveurs. Il est donc nécessaire de vérifier plusieurs autres facteurs :La validation du serveur dépend de la génération du processeur, du contrôleur de mémoire, du BIOS, du nombre de barrettes DIMM par canal, de l'organisation des rangs et de la qualification du fournisseur.Vérifiez que la référence du module correspond bien à la liste des fournisseurs qualifiés de votre carte mère ou de votre serveur.Choisissez les modules vérifiés comme conformes à la norme JEDEC et répertoriés dans la liste de modules vérifiables (QVL) du fournisseur du serveur.Une validation manuelle par rapport à la matrice de compatibilité mémoire du modèle de serveur peut encore être nécessaire.Cette approche par couches garantit que votre mémoire DDR5 ECC offre une prise en charge complète de la correction d'erreurs (ECC) sur votre plateforme spécifique. L'architecture RDIMM ECC enregistrée de la DDR5 répond à des normes strictes, et les processus de qualité SK Hynix confirment que chaque module est prêt pour un déploiement en entreprise. Fonctionnalités de gestion thermique intégréesLes charges de travail importantes génèrent de la chaleur au sein de votre serveur. Le module DDR5 ECC Registered RDIMM relève ce défi grâce à des capteurs thermiques intégrés. Ces capteurs surveillent en temps réel la température des puces DRAM. Lorsque celle-ci augmente, le module ajuste automatiquement la fréquence de rafraîchissement. Cette réaction garantit la stabilité du système sous forte charge sans compromettre les performances. La tension de fonctionnement de 1,1 V de cette RDIMM réduit déjà la dissipation thermique par rapport aux alternatives à tension plus élevée. Associée à une gestion thermique intégrée, votre mémoire serveur ECC reste dans des plages de fonctionnement sûres. Vous bénéficiez ainsi de performances constantes de 5 600 MT/s, même lors des pics de charge. Cette gestion thermique intelligente protège votre investissement et prolonge la durée de vie du module. Votre RDIMM fonctionne de manière fiable grâce à la gestion automatique de son profil thermique. La conception de la RDIMM ECC enregistrée intègre ces protections au niveau de la puce. Vous disposez ainsi d'une mémoire ECC qui protège activement vos données et votre matériel. Compatibilité des modules DDR5 RDIMM avec les plateformes d'entrepriseOptimisé pour les processeurs Intel et AMDLe choix de votre plateforme serveur détermine si cette mémoire fonctionnera à pleine vitesse. La barrette DDR5-5600 ECC RDIMM s'intègre parfaitement aux processeurs Intel Xeon Scalable de 4e et 5e générations. Les plateformes AMD EPYC série 9004 valident également ce module pour le fonctionnement ECC enregistré. Selon la fiche produit, la mémoire SK hynix DDR5-5600 est validée pour les plateformes serveur prenant en charge la mémoire ECC enregistrée, notamment les plateformes AMD EPYC série 9004. Vous bénéficiez ainsi d'une large compatibilité avec les deux principales familles de processeurs. La validation de la plateforme ne se limite pas à la compatibilité du socket. Le contrôleur mémoire intégré à chaque processeur gère la synchronisation, la tension et le comportement de rafraîchissement. Intel et AMD conçoivent ces contrôleurs selon les normes JEDEC DDR5. Votre module RDIMM DDR5 ECC Registered respecte ces mêmes normes. Cette conformité garantit un fonctionnement stable dès le premier démarrage. Vous pouvez déployer cette mémoire serveur DDR5 ECC sur des parcs informatiques hétérogènes sans réglage spécifique à la plateforme. Lignes directrices pour la population de mémoireLes installations à haute capacité nécessitent une planification minutieuse avant l'installation des modules. Vérifiez d'abord la version de votre BIOS. Les anciens firmwares peuvent ne pas reconnaître les mémoires de 64 Go ou les configurations 2Rx4. Mettez à jour votre BIOS avec la dernière version disponible auprès du fournisseur de votre serveur. Cette étape prévient les échecs de démarrage et garantit que votre système applique les paramètres de synchronisation corrects pour un fonctionnement à 5 600 MT/s. Respectez scrupuleusement les règles d'installation des barrettes de mémoire (DIMM) pour votre carte mère. Ces règles définissent l'ordre des emplacements, l'équilibre des canaux et la répartition des rangs. Un mauvais ordre d'installation peut entraîner une baisse de vitesse ou empêcher le démarrage. Consultez la liste des fournisseurs qualifiés (QVL) de votre fournisseur de serveur avant tout achat. Cette liste recommande de vérifier la QVL de la carte mère pour une compatibilité optimale. Cette vérification confirme que vos modules RDIMM ECC répondent aux exigences testées par le fournisseur. Vous protégez ainsi votre déploiement des problèmes de compatibilité et bénéficiez d'une protection ECC complète sur tous les canaux.  Vos serveurs d'entreprise ont besoin d'une mémoire performante à tous les niveaux. La mémoire DDR5-5600 ECC RDIMM allie fiabilité grâce à la mémoire ECC et à une conception enregistrée, performances de 5 600 MT/s avec une faible consommation de 1,1 V et une large compatibilité avec les plateformes. Cette mémoire DDR5 ECC RDIMM enregistrée n'est pas un composant aux fonctionnalités limitées. C'est une solution équilibrée pour les datacenters modernes. Vous bénéficiez d'une bande passante accrue, d'une efficacité énergétique améliorée et d'une évolutivité optimisée, le tout dans un seul module. L'architecture enregistrée protège vos charges de travail critiques. La mémoire SK hynix DDR5-5600 répond à ces exigences. En tant que responsable informatique, considérez cette mémoire DDR5 ECC comme la norme pour vos nouveaux déploiements de serveurs. Vous garantissez des gains de performance immédiats et une évolutivité de votre infrastructure à long terme. Choisissez la mémoire serveur ECC pour accompagner votre croissance. FAQQu'est-ce qui distingue cette mémoire DDR5 de la RAM standard ?Ce module combine la correction d'erreurs ECC avec une conception enregistrée. Vous bénéficiez ainsi d'une intégrité des données et d'une stabilité du signal optimales. La RAM standard ne possède ni l'une ni l'autre de ces caractéristiques.Comment ECC protège-t-il les données de votre entreprise ?La correction d'erreurs ECC corrige automatiquement les erreurs de mémoire à un bit. Cela évite les pannes système et la corruption des données. Vos applications critiques fonctionnent sans interruption.Quelles sont les spécifications techniques de ce module de 64 Go ?Les principales caractéristiques techniques de la mémoire SK hynix DDR5-5600 incluent une fréquence de 5 600 MHz, une capacité de 64 Go et une architecture 2Rx4. Le module fonctionne sous une tension de 1,1 V avec une latence CAS de 46 bits (CL46).Comment une barrette RDIMM enregistrée ECC améliore-t-elle la stabilité du serveur ?L'architecture RDIMM à code ECC achemine les signaux via une puce RCD, réduisant ainsi la charge électrique sur le contrôleur de mémoire. Votre serveur prend alors en charge davantage de modules.Quels processeurs prennent en charge ce module DDR5 ?Ce module DDR5 prend en charge les processeurs Intel Xeon Scalable et AMD EPYC. Les deux plateformes valident le fonctionnement ECC enregistré. Votre déploiement fonctionne sur des parcs de serveurs hétérogènes.
  • Comment choisir des émetteurs-récepteurs optiques haut débit pour les réseaux de centres de données d'IA
    Comment choisir des émetteurs-récepteurs optiques haut débit pour les réseaux de centres de données d'IA
    September 20, 2026
    Choisir émetteurs-récepteurs optiques à haut débit En adaptant cinq caractéristiques à votre infrastructure : vitesse, portée, type de fibre, format et compatibilité avec les commutateurs, vous privilégiez la vitesse, la portée et la compatibilité avec les commutateurs. Le port le plus rapide est rarement le meilleur choix. Pour les charges de travail informatiques accélérées, la faible latence, la forte densité de ports et une consommation d'énergie prévisible sont essentielles. Commencez par analyser la charge de travail, puis élargissez votre champ d'action. Cette méthode garantit la reproductibilité du choix des émetteurs-récepteurs et assure que leur vitesse est liée aux distances de liaison réelles plutôt qu'aux arguments marketing. Chaque émetteur-récepteur ajouté modifie également l'alimentation, le refroidissement et l'infrastructure de câblage du rack. Planifiez la densité et les migrations au plus tôt. Un partenaire fiable tel que X REACH LIMITÉE Nous fournissons des solutions optiques et de câblage adaptées, afin que votre infrastructure reste cohérente malgré son expansion. Points clés à retenirAdaptez la vitesse de l'émetteur-récepteur au rôle du port, et non à la valeur la plus élevée. Utilisez 100 Gbit/s pour l'accès, 400 Gbit/s pour le réseau dorsal et 800 Gbit/s pour les liaisons montantes.Pour les nouvelles installations d'IA, privilégiez la fibre monomode. Elle permet de réduire de quatre fois le nombre de fibres et prend en charge les mises à niveau vers 800G.Testez chaque module en mode isolé avant le déploiement. Les limitations du firmware sont à l'origine de la plupart des défaillances, notamment lors de la répartition d'un débit de 800 Gbit/s en 4 x 100 Gbit/s.Calculez la consommation électrique par port pour chaque rack. Les modules 800G ajoutent 14 à 18 W, ce qui augmente la charge thermique de 1,5 à 2 fois. SNiveaux de vitesse pour les émetteurs-récepteurs optiques de centres de données IA haute vitesseComparaison des modèles 100G, 400G et 800GChaque niveau de débit remplit un rôle distinct au sein de l'infrastructure. Le 100G est déployé au niveau des serveurs périphériques pour l'accès et la gestion. Le 400G est installé au niveau du cœur du réseau et pour l'interconnexion des GPU au sein d'une même baie. Le 800G est réservé aux liaisons montantes du cœur et aux liaisons inter-pods transportant le trafic agrégé. Le choix optimal dépend de la charge de travail, du type de port et de la distance de liaison. La vitesse brute seule est peu informative. Un port 400G d'une portée de 500 mètres répond à un besoin différent de celui d'un port d'une portée de 2 kilomètres.Émetteur-récepteurFibre / ConnecteurPortée maximale400G-DR4Monomode / MPO-12500 m400G-FR4LC monomode / duplex2 kmCet écart est important. Choisissez DR4 pour les liaisons intra-rangée et inter-rangées. Optez pour FR4 lorsque la liaison traverse un couloir. La vitesse de l'émetteur-récepteur optique reste constante dans les deux cas, mais la portée détermine le module le mieux adapté à votre configuration. Pourquoi les tissus IA visent les 800G et 1,6TL'entraînement des IA bouleverse les calculs de bande passante. Un seul entraînement d'une classe GPT peut saturer des liaisons 100G des milliers de fois. Les clusters de GPU NVIDIA connectent plus de 100 000 accélérateurs au sein d'une même infrastructure. Chaque GPU requiert une bande passante d'interconnexion de 400 à 800 Gbit/s. La capacité agrégée atteint 80 pétabits par seconde pour un tel cluster.L'entraînement de l'IA nécessite aujourd'hui 800G et 1,6T d'ici 2026, alors que 400G suffisaient pour les charges de travail cloud générales.La communication avec le serveur de paramètres pour la synchronisation des gradients requiert à elle seule 3 à 5 Tbit/s. Toutes les opérations de réduction nécessitent un accès simultané à haut débit à chaque nœud. Le stockage des points de contrôle et l'alimentation du pipeline de données ajoutent une charge continue. Émetteurs-récepteurs optiques à large bande passante absorber cette pression en augmentant le nombre de voies par module. Le déploiement du moteur 1.6T suit une séquence claire :2025–2026 : Déploiement précoce et montée en puissance, concentrés dans les clusters d’entraînement de l’IA et les couches spines à haute capacité.2026–2027 : Adoption plus large de l’infrastructure IA, avec des environnements mixtes 400G/800G/1,6T restant courants.2027 et au-delà : La feuille de route prévoit des modules de 3,2 T, avec l’OSFP-XD positionné pour une densité de voies plus élevée.La dynamique des fournisseurs confirme cette évolution. Marvell a commercialisé en grande série son processeur DSP Ara 1,6T PAM4 gravé en 3 nm dès mars 2026. Cisco a annoncé des systèmes Silicon One G300 à 64 ports capables de fonctionner à 1,6 Tbit/s. Arista a annoncé des plateformes 64 ports 1,6 Tbit/s au sein de la gamme 7060XE7. Les premiers déploiements 1,6 Tbit/s étaient proposés à des prix élevés, supérieurs à 3 000 dollars l'unité. Les normes restent en retard sur le matériel. En juillet 2026, la norme IEEE P802.3dj était encore au stade de la version préliminaire 3.1. Sa publication finale est en cours. Vos spécifications d'approvisionnement doivent donc faire la distinction entre la « conception conforme à la version préliminaire actuelle de la norme P802.3dj » et la conformité à une norme finale publiée. La révision 5.1 de la norme OSFP MSA inclut des dispositions relatives à l'OSFP1600, et l'OIF a publié la version 5.4 du CMIS en mai 2026. Planifiez votre infrastructure en fonction de ce rythme. Optez pour une connectivité 800G pour vos clusters d'IA actuels et assurez-vous que vos commutateurs et votre câblage prennent en charge une future mise à niveau vers 1,6T. Cette approche protège votre investissement et préserve l'efficacité de votre infrastructure malgré la croissance du trafic réseau. Portée, fibre optique et émetteurs-récepteurs optiques pour les réseaux de centres de donnéesClasses de portée SR, DR, FR et LRLa classe de portée indique la distance maximale qu'une liaison peut parcourir. À 400 Gbit/s, les quatre classes courantes couvrent des distances très différentes.Type d'émetteur-récepteurDistance maximale supportéeFibre/Moyen400G SR8100 mOM3 multimode (MPO-16, 850 nm)400G DR4500 mMonomode (MPO-12, 1310 nm)400G FR42 kmMonomode (LC duplex, CWDM)400G LR410 kmMonomode (LC duplex, CWDM)Le SR8 est utilisé pour les liaisons internes de moins de 100 mètres. Le DR4 gère les liaisons entre les nœuds de périphérie et les nœuds centraux au sein d'une même salle. Le FR4 et le LR4 sont utilisés pour les liaisons plus longues, y compris les liaisons entre bâtiments. Émetteurs-récepteurs optiques longue distance par exemple, les modules LR4 acheminent le trafic à travers un campus sans régénération. Architecture monomode vs multimode et MPOLa fibre monomode domine désormais les nouvelles architectures d'IA. À 400 Gbit/s, le SR8 utilise 16 fibres via un connecteur MPO-16. Le DR4, quant à lui, utilise un connecteur MPO-12 et couvre 500 mètres de fibre monomode. Cette réduction du nombre de fibres diminue l'encombrement du câble et simplifie l'architecture MPO. Le coût est également un facteur déterminant. Un module SR8 400G coûte environ 219 $, tandis qu'un DR4 400G coûte environ 549 $. Le multimode est plus avantageux à court terme pour les liaisons courtes. Le monomode, quant à lui, est préférable pour les déploiements à long terme. Le seuil de transition se situe autour de 200 à 250 mètres pour les déploiements 100G. Au-delà, le monomode devient à la fois techniquement indispensable et plus économique sur le long terme. Le choix de votre émetteur-récepteur détermine l'évolutivité de votre topologie. La fibre monomode peut être mise à niveau vers le 800G DR8 en doublant le nombre de voies. La fibre multimode ne dispose d'aucun chemin direct à 800G sans l'ajout de nouvelles liaisons MPO-16. Planifiez votre infrastructure fibre dès le départ et vous éviterez ainsi des travaux de recâblage coûteux ultérieurement. Compatibilité avec les facteurs de forme et les commutateursQSFP-DD, OSFP et QSFP112Le format détermine la bande passante disponible sur la façade et la chaleur dégagée par chaque port. Le QSFP-DD est un format courant pour les modules 400G, tandis que l'OSFP cible les débits de 800G et 1,6T, avec une prise en charge définie dans la révision 5.1 de la norme OSFP MSA. Le QSFP112 est un autre format 400G utilisant moins de voies, mais plus rapides. Assurez-vous que le format est compatible avec votre ASIC de commutation et votre système de refroidissement avant de faire votre choix. Vérifications des ports, des sorties et de l'interopérabilitéLa fonction Breakout transforme un port 400G en quatre liaisons 100G. Cette configuration convient à l'architecture spine-to-leaf, à l'extension de clusters GPU et à la migration progressive de 100G vers 400G. Elle nécessite un profil de port de commutateur adapté, des faisceaux de câbles MPO Breakout, des optiques distantes compatibles et un mappage précis des voies. Vérifiez la compatibilité de chaque module avec la matrice du fabricant du commutateur, en vous basant sur votre référence et votre version logicielle exactes. Assurez-vous de la classe de puissance et de la concordance des versions CMIS entre le firmware du commutateur et l'émetteur-récepteur. Testez d'abord les modes de dérivation en laboratoire. Les modules économiques fonctionnent souvent correctement à 400 Gbit/s natif, mais peuvent rencontrer des problèmes lors de la dérivation en raison de limitations du firmware ou du mappage des voies.La compatibilité varie selon le fournisseur et le module. Considérez le choix de l'émetteur-récepteur comme un critère de compatibilité, et non de vitesse ; ainsi, votre infrastructure d'IA se connectera sans problème dès la première tentative. Puissance, refroidissement et fiabilité des réseaux d'IABilans énergétiques et thermiques par portUne vitesse de transmission optique plus élevée génère davantage de chaleur par module. Les modules 800G consomment plus d'énergie que les modules 400G, ce qui impacte le budget de votre rack. Par bit transmis, le 800G est plus efficace, favorisant la migration vers les clusters d'IA. Cependant, chaque module contribue à la dissipation thermique nécessaire. La capacité de refroidissement limite désormais la densité des racks. Le passage d'une alimentation de 400 Gbit/s à 800 Gbit/s par port augmente la charge thermique du rack ; par conséquent, un système de refroidissement conçu pour 400 Gbit/s peut ne pas convenir à 800 Gbit/s. Risques liés à la poussière, à la chaleur et aux contraintes mécaniquesLes racks d'IA atteignent des densités de puissance élevées. La température des GPU reste élevée pendant de longues périodes. Vos émetteurs-récepteurs optiques réseau de cluster GPU doivent y résister. Les systèmes d'évacuation d'air côté ports ajoutent des contraintes thermiques, et un flux d'air instable réduit la marge de liaison.Effet de la températureImpact sur les performances optiquesImplications en matière de fiabilitétempérature élevéePuissance optique de sortie réduitestabilité de la marge de liaison inférieurefluctuation de températureAugmentation de la variation et de la gigue du signalRisque BER plus élevéContrôle thermique stablePerformances optiques constantesDurée de vie prolongée du moduleLa chaleur modifie également la longueur d'onde du laser. Dans les systèmes WDM, cette dérive peut faire sortir le signal de la fenêtre de filtrage du récepteur. Le taux d'erreur binaire (TEB) augmente alors, et la liaison peut être complètement interrompue. La poussière et les contraintes mécaniques aggravent le problème. Les faces d'extrémité MPO contaminées diffusent la lumière et réduisent la marge. L'insertion répétée use les férules des connecteurs. Des optiques de haute qualité réduisent les défaillances dues à la poussière, à la chaleur et aux contraintes, protégeant ainsi votre infrastructure et ses performances pendant de nombreuses années. Cadre de sélection et erreurs courantesOrdre de sélection étape par étapeUn ordre de sélection reproductible permet de baser le choix de l'émetteur-récepteur sur votre infrastructure plutôt que sur une fiche technique. Suivez ces étapes dans l'ordre :Définissez la charge de travail. Identifiez si la liaison sert à l'interconnexion de GPU, à l'agrégation de nœuds ou au stockage. Les clusters d'entraînement d'IA privilégient les liaisons courtes, denses et à faible latence.Réglez la vitesse. Adaptez la bande passante au rôle du port, et non à la valeur la plus élevée disponible.Déterminez la portée. Mesurez la longueur réelle de la fibre. Choisissez la fibre SR8 pour les fibres multimodes jusqu'à 100 m, la fibre DR8 pour les fibres monomodes jusqu'à 500 m et la fibre FR4 pour les fibres monomodes jusqu'à 2 km.Vérifiez le réseau de fibre optique. Le passage du multimode au monomode augmente considérablement les coûts de déploiement.Choisissez le format. Vérifiez la compatibilité OSFP ou OSFP-XD avec la bande passante de votre circuit intégré spécifique au commutateur (ASIC).Vérifiez la compatibilité. Consultez la liste des fournisseurs, confirmez le codage de l'EEPROM et effectuez des tests sur du matériel réel avant un déploiement à grande échelle.Consommation électrique et refroidissement optimaux. Additionnez la puissance par port pour chaque port du rack.Prévoyez des pièces de rechange. Conservez un stock modeste par type d'optique.Cette séquence protège votre budget d'infrastructure et votre calendrier de déploiement. Les pièges qui font dérailler les déploiements d'IALe module le moins cher d'un devis est souvent celui qui coûte le plus cher sur le long terme. Acheter un module LR4 pour une liaison d'un kilomètre revient à acheter une distance inutilisée par le réseau et à augmenter la consommation électrique à chaque port. L'erreur inverse a également un impact négatif. Un module DR4 sur une distance de 700 à 1 000 mètres peut entraîner des modifications de conception ou des remplacements d'urgence une fois la marge de sécurité épuisée. La consommation électrique aggrave ce problème : même une légère augmentation de la puissance se multiplie sur des centaines de ports. Les erreurs de câblage sont tout aussi fréquentes. Faites attention aux points suivants :Type de connecteur MPO incorrect. Le SR8 nécessite un connecteur MPO-16, le DR4 nécessite un connecteur MPO-12.Incompatibilité de polarité.Connecteurs APC et UPC compatibles.Connecteur de sexe incorrect. Les émetteurs-récepteurs utilisent des connecteurs MPO mâles. Les câbles de brassage doivent utiliser des connecteurs femelles.Câblage de dérivation incorrect pour les liaisons 800G.Mauvaise planification de la longueur.Le risque lié à l'approvisionnement mérite une attention tout aussi soutenue. Une conception reposant sur un seul module codé provenant d'un fournisseur unique peut bloquer l'ensemble de la production en cas de pénurie de processeurs de signal numérique (DSP), de lasers EML ou de capacités d'encapsulation. La qualification multi-fournisseurs et une politique de pièces de rechange clairement définie permettent de réduire ce risque.Les coûts liés aux temps d'arrêt rendent ces écueils concrets. Un cluster de 1 000 GPU doté d'optiques de faible qualité peut subir des pertes importantes. Les émetteurs-récepteurs optiques longue distance pour centres de données et les émetteurs-récepteurs optiques pour réseaux de clusters GPU présentent chacun des modes de défaillance spécifiques. Le choix d'émetteurs-récepteurs optiques haut débit pour centres de données exige une planification rigoureuse. Considérez le choix de l'émetteur-récepteur comme une décision à long terme. Votre infrastructure, ses performances et son efficacité en dépendent.  Choisissez une configuration adaptée à votre infrastructure : vitesse, portée, fibre, format, compatibilité et fonctionnement. Cette approche garantit que les émetteurs-récepteurs optiques haute vitesse pour centres de données IA répondent aux besoins réels de vos charges de travail. Les réseaux d'IA tirent profit d'une planification anticipée. La densité, la consommation d'énergie et les voies de migration doivent être étudiées avant tout achat. Les acquisitions ponctuelles augmentent les coûts et les risques pour votre infrastructure. Vérifiez la compatibilité de chaque optique avec la liste de compatibilité de votre fournisseur de commutateurs. Privilégiez un partenaire fiable pour une qualité et un approvisionnement constants. Une planification rigoureuse protège votre infrastructure et garantit l'efficacité de votre réseau lors de son évolution. FAQQuelle vitesse choisir en premier pour une infrastructure IA ?Commencez par définir le rôle des ports. Utilisez 100 Gbit/s pour l'accès aux serveurs, 400 Gbit/s pour les liaisons du réseau dorsal et des GPU en rack, et 800 Gbit/s pour les liaisons montantes du réseau dorsal et les liaisons inter-pods. Adaptez la bande passante à la charge de travail plutôt que de rechercher systématiquement la valeur la plus élevée sur une fiche technique.Comment choisir entre SR8, DR4, FR4 et LR4 ?Mesurez la longueur réelle de la fibre. La fibre SR8 couvre les liaisons multimodes jusqu'à 100 m. La fibre DR4 atteint 500 m en monomode. Les fibres FR4 et LR4 s'étendent jusqu'à 2 km et 10 km respectivement. Les émetteurs-récepteurs optiques longue distance pour centres de données, tels que les LR4, permettent de couvrir un campus sans régénération.Pourquoi la fibre monomode domine-t-elle les nouvelles constructions d'IA ?La fibre monomode domine les nouvelles infrastructures d'IA grâce à sa portée et sa bande passante supérieures. À 400 Gbit/s, la norme DR4 utilise un connecteur MPO-12, tandis que la norme SR8 utilise un connecteur MPO-16 ; la fibre monomode permet donc de réduire l'encombrement du câble. Elle assure également une migration fluide vers la norme DR8 à 800 Gbit/s.Qu'est-ce qui provoque le plus souvent des ruptures de liens de dérivation 800G ?La plupart des pannes sont dues aux limitations du firmware et du mappage des voies. Un module fonctionnant correctement à 400 Gbit/s natif peut présenter des défaillances lors d'une utilisation en mode 4x100 Gbit/s. Avant toute mise à l'échelle, vérifiez le profil du port du commutateur, utilisez le faisceau MPO approprié et testez les modes de fonctionnement en laboratoire.Quelle quantité de puissance et de chaleur chaque port ajoute-t-il ?Les modules 800G consomment plus d'énergie que les modules 400G ; par conséquent, le passage de 400G à 800G augmente la charge thermique du rack. Additionnez la consommation par port pour chaque port, puis vérifiez que votre système de refroidissement est adapté à cette consommation totale.Pourquoi planifier les pièces de rechange et la qualification multi-fournisseurs ?Les temps d'arrêt des GPU peuvent s'avérer coûteux. Un cluster de 1 000 GPU présentant un taux de défaillance optique important peut être immobilisé pendant de nombreuses heures. La qualification de plusieurs fournisseurs et un stock de pièces de rechange bien défini protègent votre infrastructure contre les pénuries d'approvisionnement et les risques liés à une source unique. Une planification rigoureuse garantit l'efficacité de cette infrastructure lors de sa mise à l'échelle.
  • Pourquoi la RTX 5090 est la meilleure carte graphique pour les jeux et l'IA
    Pourquoi la RTX 5090 est la meilleure carte graphique pour les jeux et l'IA
    September 17, 2026
    La RTX 5090 s'impose comme la meilleure carte graphique pour le jeu et l'IA. Elle offre une puissance inégalée. NVIDIA GeForce RTX 5090Aucune autre carte graphique ne peut rivaliser. Ce fleuron du jeu vidéo repose sur trois piliers de domination. Premièrement, la puissance de calcul massive de ses 21 760 cœurs CUDA garantit des fréquences d'images exceptionnelles. Deuxièmement, le DLSS 4.5 avec Multi-Frame Generation améliore les performances des jeux 4K avec lancer de rayons jusqu'à 35 %, selon les benchmarks NVIDIA. Troisièmement, les 32 Go de GDDR7 accélèrent l'entraînement des modèles. La RTX 5090 est compatible PCIe 5.0 x16 et DisplayPort 2.1. Ces performances établissent une nouvelle référence. Benchmarks, spécifications et comparatifs directs confirment chaque affirmation. Cette carte graphique redéfinit les limites du possible et aucune autre ne peut l'égaler. Points clés à retenirLa RTX 5090 domine le jeu vidéo avec ses 21 760 cœurs CUDA et la technologie DLSS 4.5, offrant une expérience de jeu fluide en 4K et 8K.Ses 680 cœurs Tensor et ses 32 Go de mémoire GDDR7 accélèrent l'entraînement et l'inférence de l'IA, gérant facilement les grands modèles.Vous bénéficiez d'une bande passante mémoire supérieure de 78 % à celle de la RTX 4090, ce qui accélère les tâches gourmandes en données telles que l'entraînement de modèles et le montage vidéo 8K.Cette carte nécessite une alimentation de 950 W en raison de sa consommation électrique de 575 W, prévoyez donc une alimentation robuste.Optez pour la version supérieure si vous exigez des performances maximales pour les jeux, l'IA ou le travail professionnel ; passez votre chemin si vous jouez en 1080p.Performances de jeu de la RTX 5090  Puissance brute et performances de référenceL'architecture Blackwell assure le rendu de chaque image sur la RTX 5090. Elle intègre 21 760 cœurs CUDA et 170 cœurs RT de quatrième génération, soit une augmentation d'environ 33 % par rapport au modèle précédent. Le tableau ci-dessous présente une comparaison directe.SpécificationRTX 5090RTX 4090Cœurs CUDA21 76016 384Cœurs RT170128Ce gain de puissance brute se traduit directement par des performances exceptionnelles en jeu. Sur 3DMark Port Royal, un test axé sur le ray tracing, la RTX 5090 obtient un score de 46 823 avec un Intel Core i9-14900K. Un second test, avec un AMD Ryzen 9 9950X3D, atteint 46 808. Sur Time Spy Extreme, un benchmark DirectX 12 en résolution 4K, la carte obtient 26 815 avec le Ryzen 9 9950X3D. Ces résultats placent le GPU en tête du classement Hall of Fame. Vous bénéficiez ainsi d'une fluidité optimale en 4K sur tous les titres modernes. En 8K, la carte maintient une fréquence d'images jouable même avec les moteurs graphiques les plus exigeants. La RTX 5090 est équipée d'une interface PCIe 5.0 x16 pour une latence ultra-faible. Les sorties DisplayPort 2.1 et HDMI 2.1 prennent en charge les moniteurs 4K et 8K à taux de rafraîchissement élevé. Cette connectivité garantit que votre écran ne limitera jamais les performances du processeur graphique. Ray Tracing et DLSS 4.5Le ray tracing sur ce GPU atteint des sommets. Les 170 cœurs RT de quatrième génération gèrent le rendu en temps réel avec une efficacité remarquable. Vous bénéficiez ainsi d'un éclairage, d'ombres et de reflets photoréalistes dans les jeux compatibles. La RTX 5090 associe ce matériel au DLSS 4.5 et à la génération multi-images. Cette technologie insère des images supplémentaires entre celles rendues. Le nombre d'images par seconde dans les titres les plus exigeants est ainsi considérablement amélioré. NVIDIA DLSS 4.5 a été conçu pour fonctionner avec un large catalogue de jeux. Activez-le dans les paramètres et profitez de meilleures performances sans compromis visuel majeur. L'association d'un matériel RT performant et de DLSS rend le ray tracing 4K accessible à tous. La GeForce RTX 5090 bénéficie également d'une bande passante mémoire élevée. Ses 32 Go de VRAM GDDR7 sur un bus 512 bits offrent jusqu'à 1 792 Go/s. Cette bande passante mémoire alimente le GPU en données rapidement. Un débit mémoire élevé est crucial pour les textures volumineuses et les scènes complexes. Grâce à cet avantage, la carte maintient un nombre d'images par seconde constant. Pour le jeu compétitif, le PCIe 5.0 x16 réduit encore la latence. Vous réagissez plus vite dans les jeux rapides. La RTX 5090 offre une expérience de jeu inégalée. Ses performances réelles dans les jeux avec ray tracing font référence. Chaque test de performance confirme la domination de cette carte dans le monde du jeu vidéo. Performances et charges de travail de l'IA NVIDIA  Cœurs Tensor et 32 ​​Go de GDDR7La RTX 5090 transforme les charges de travail d'IA grâce à ses cœurs Tensor de cinquième génération. Ces unités spécialisées accélèrent les opérations matricielles au cœur de chaque réseau neuronal. Vous obtenez 32 Go La mémoire GDDR7 sur bus 512 bits offre une configuration permettant de traiter des ensembles de données massifs sans recourir à la mémoire système. La bande passante mémoire atteint 1 792 Go/s, contre 1 008 Go/s pour la RTX 4090. On obtient ainsi un gain de 78 % en bande passante mémoire. Cet avantage est crucial pour l'entraînement de modèles de langage complexes ou le traitement d'images haute résolution. La GeForce RTX 5090 alimente ses cœurs CUDA en données à une vitesse exceptionnelle. L'entraînement de vos modèles est plus rapide car le GPU ne manque jamais de données. La mémoire VRAM GDDR7 de 32 Go prend également en charge l'inférence sur des modèles dépassant 24 Go. Vous traitez des lots plus importants et atteignez un débit supérieur. Le calcul scientifique bénéficie également de cette bande passante mémoire. Les simulations en dynamique des fluides ou en modélisation moléculaire exigent un accès rapide aux données. La RTX 5090 garantit cet accès de manière constante. La protection matérielle contre les coupures de courant assure une fiabilité de niveau professionnel. Vos longs entraînements restent opérationnels même en cas de coupure de courant inattendue, sans corruption de données. Cette caractéristique distingue la RTX 5090 des GPU grand public. Écosystème logiciel et benchmarks d'IANVIDIA maintient l'écosystème CUDA comme norme du secteur pour le développement de l'IA. Vous accédez à des bibliothèques optimisées pour l'apprentissage profond, la vision par ordinateur et le calcul scientifique. Des frameworks populaires comme PyTorch et TensorFlow fonctionnent nativement sur cette plateforme. Le GPU accélère l'entraînement, l'inférence et l'ajustement des modèles. Des benchmarks en conditions réelles confirment ce gain de performance. Lors de l'entraînement de ResNet-50, la RTX 5090 traite 1 128,6 échantillons par seconde en précision FP32, contre 757,5 pour la RTX 4090. En précision FP16, la RTX 5090 atteint 1 623,9 échantillons par seconde, contre 1 360,6 pour le modèle précédent. Ces résultats démontrent des gains constants quel que soit le niveau de précision. Vos pipelines d'apprentissage profond s'exécutent plus rapidement. Le GPU excelle également dans les charges de travail d'inférence, permettant le déploiement de modèles entraînés avec une latence réduite. Les applications de calcul scientifique bénéficient de la même architecture. Les chercheurs exécutent des simulations qui nécessitaient auparavant plusieurs unités GPU. L'écosystème CUDA prend en charge ces charges de travail grâce à des outils éprouvés. Vous trouverez facilement de la documentation, un support communautaire et une assistance aux entreprises. La technologie DLSS exploite également les cœurs Tensor pour les jeux. Cette double fonctionnalité rend la RTX 5090 précieuse aussi bien pour la recherche en IA que pour le divertissement. Le GPU gère efficacement le rendu 3D professionnel et la production d'images de synthèse. Les monteurs vidéo bénéficient d'une lecture 8K en temps réel. Les studios de production virtuelle s'appuient sur ces performances pour les jumeaux numériques. Le GPU répond aux normes de fiabilité des entreprises. La protection matérielle contre les pertes de courant garantit la continuité de votre travail en cas de coupure de courant. La RTX 5090 s'impose comme le choix de référence pour les professionnels de l'IA exigeant des performances maximales.Comment ce GPU se compare-t-il à ses concurrents ? Comparaison avec les fleurons de la génération précédenteLes gains les plus importants sont visibles lorsqu'on compare directement la RTX 5090 et la RTX 4090. La nouvelle carte embarque 21 760 cœurs CUDA contre 16 384, et ses 32 Go de mémoire GDDR7 doublent les 24 Go de l'ancienne. La bande passante mémoire passe de 1 008 Go/s à 1 792 Go/s, soit une augmentation de 78 %. Cette bande passante supplémentaire permet d'alimenter des modèles de langage complexes et des textures 8K sans ralentissement. Lors de l'entraînement sur ResNet-50, la RTX 5090 atteint 1 128,6 échantillons par seconde en FP32, tandis que la RTX 4090 se limite à 757,5. Vos entraînements se terminent plus rapidement et la latence d'inférence diminue. La consommation électrique confirme cette tendance. La RTX 5090 affiche une consommation de 575 W contre 450 W pour la RTX 4090. En jeu, la nouvelle carte consomme 685 W contre 610 W. Les pics de consommation atteignent 1 150 W contre 850 W. Il vous faut donc une alimentation de 950 W, et non celle de 850 W recommandée pour l'ancien modèle haut de gamme.La RTX 5090 affiche une consommation de 575 W contre 450 W pour la RTX 4090, ce qui représente une augmentation significative de la consommation d'énergie parallèlement au gain de performance. Par rapport aux concurrents de génération actuelleLa carte graphique AMD RX 7900 XTX consomme 355 W à pleine charge et nécessite une alimentation de 800 W. La RTX 5090 consomme davantage, mais offre des performances nettement supérieures pour les jeux et les tâches d'IA. Son écosystème CUDA lui confère un avantage logiciel inégalé. Les applications professionnelles telles que le rendu 3D et la production d'images de synthèse sont exécutées plus rapidement sur ce GPU.Le prix de la RTX 5090 reflète cet écart. Son coût initial est plus élevé, et il inclut également le refroidissement et l'alimentation. Un boîtier robuste et une alimentation de 950 W de qualité contribuent à son prix total. Malgré cela, aucune carte graphique concurrente n'offre des performances comparables aux tests de performance. La RTX 5090 s'impose comme la carte graphique de référence pour les acheteurs exigeant des performances maximales.  La RTX 5090 mérite amplement son titre de meilleure carte graphique pour le jeu et l'IA. Chaque test de performance le confirme. La NVIDIA GeForce RTX 5090 offre des fréquences d'images inégalées en 4K et 8K. Ses 32 Go de GDDR7 accélèrent l'entraînement des modèles. Cette carte graphique est idéale pour les joueurs en 4K et 8K, les chercheurs en IA, les créateurs de contenu et les utilisateurs de stations de travail. Si vous jouez en 1080p, vous pouvez vous en passer. Son prix et son coût reflètent son statut de produit haut de gamme. Une alimentation de 950 W est également nécessaire. Cette carte graphique NVIDIA place la barre très haut pour les générations futures. Aucune autre carte graphique n'égale ses performances. Les meilleures cartes graphiques suivront son exemple. Son prix d'entrée est élevé. FAQQuelle alimentation est nécessaire pour la RTX 5090 ?Il vous faut une alimentation de 950 W. La carte consomme 575 W en pleine charge, et les pics de consommation peuvent être plus importants. Une alimentation de qualité, capable de fournir une puissance suffisante, garantit une meilleure stabilité. La RTX 5090 exige une marge de puissance supérieure aux modèles haut de gamme précédents.Comment 32 Go de VRAM aident-ils les charges de travail d'IA ?Vous pouvez exécuter des modèles plus volumineux sans avoir recours à la mémoire système. Les 32 Go de VRAM gèrent les grands modèles de langage et les ensembles de données haute résolution. L'entraînement est plus rapide grâce à l'accès rapide aux données par le GPU. Cette capacité permet l'inférence sur des modèles dépassant 24 Go.La technologie DLSS 4.5 améliore-t-elle les performances de jeu ?Oui. Le DLSS 4.5 avec génération multi-images insère des images supplémentaires entre les images rendues. Le nombre d'images par seconde augmente considérablement dans les jeux les plus exigeants. Activez cette option dans les paramètres pour bénéficier d'un rendu 4K fluide. Cette technologie est compatible avec un large catalogue de jeux.Devriez-vous passer d'une RTX 4090 à ce modèle ?Vous bénéficiez de 78 % de bande passante mémoire supplémentaire et d'environ 33 % de cœurs CUDA en plus. Le GPU Nvidia accélère l'entraînement des modèles et assure un rendu fluide du contenu 8K. Son prix est élevé et il nécessite une nouvelle alimentation. Optez pour cette solution si vous recherchez des performances maximales.Ce GPU est-il compatible avec les charges de travail professionnelles ?Oui. Le GPU Nvidia gère le rendu 3D, la production d'images de synthèse et le montage vidéo 8K en temps réel. La protection matérielle contre les coupures de courant renforce la fiabilité en entreprise. L'écosystème CUDA prend en charge l'apprentissage profond et le calcul scientifique. Ce GPU répond aux exigences des stations de travail.
  • Qu'est-ce qu'un SSD et comment fonctionne-t-il en 2026 ?
    Qu'est-ce qu'un SSD et comment fonctionne-t-il en 2026 ?
    September 03, 2026
    Vous appuyez sur le bouton d'alimentation. Votre ancien ordinateur met une minute à démarrer. Le nouveau est prêt en quelques secondes. Vous êtes-vous déjà demandé pourquoi ? La réponse réside dans le stockage. Votre nouvelle machine utilise un SSD, un disque à semi-conducteurs. Ce type de stockage repose sur des puces mémoire, et non sur des pièces mobiles. La comparaison entre les anciens disques durs et les SSD met en évidence cette différence. Un disque dur (HDD) utilise des plateaux rotatifs. Un SSD stocke les données sur de la mémoire flash, ce qui le rend plus rapide et plus fiable. Cette différence de vitesse est impressionnante. Le tableau ci-dessous indique les temps de démarrage typiques.SystèmeTemps de démarrage du disque dur (secondes)Temps de démarrage du SSD (secondes)Windows 1160–9012–17Linux Ubuntu45–708–15Ce gain de performance est dû à sa conception à semi-conducteurs. L'absence de pièces mobiles réduit la latence et vous permet d'accéder instantanément à vos fichiers.Points clés à retenirLes SSD utilisent de la mémoire flash, et non des pièces mobiles ; ils sont donc plus rapides et plus fiables que les disques durs.Choisissez un SSD NVMe pour une vitesse maximale, notamment pour les jeux ou les tâches exigeantes.Les disques SSD sont silencieux, durables et consomment moins d'énergie, ce qui les rend idéaux pour les ordinateurs portables.Passez à un SSD pour des temps de démarrage plus rapides et de meilleures performances globales.Tenez compte de vos besoins et de votre budget lors du choix d'un SSD, car ils coûtent plus cher par gigaoctet que les disques durs.Comment les disques SSD stockent les donnéesMémoire flash NAND : les cellules de stockage numériqueLes disques SSD utilisent une mémoire flash non volatile. Cela signifie que les données restent intactes même lorsque vous éteignez votre ordinateur. Imaginez une immense grille de minuscules cases. Chaque case, appelée cellule NAND, contient une charge électrique. Cette charge représente vos données sous forme de code binaire : des 0 et des 1. La présence ou l’absence de charge détermine la valeur stockée.Les cellules de mémoire NAND ne contiennent pas toutes la même quantité de données. Les fabricants les classent selon le nombre de bits stockés par chaque cellule. Le tableau ci-dessous présente les types les plus courants que vous rencontrerez en 2026.Type de celluleBits par celluleSLC1MLC2TLC3QLC4Plus de bits par cellule signifient un coût inférieur et une capacité accrue. Cependant, cette densité a un coût : la durée de vie est réduite. Chaque cellule ne peut supporter qu'un nombre limité de cycles de programmation/effacement avant de devenir inutilisable. Le tableau ci-dessous illustre les plages de durée de vie typiques.Type NANDBits par celluleEndurance typique (cycles de programmation/effacement)SLC150 000 – 100 000MLC23 000 – 10 000TLC31 000 – 3 000QLC4150 – 1 000Les disques durs modernes s'affranchissent des limitations d'endurance grâce à l'architecture 3D NAND. Au lieu de disposer les cellules à plat sur un seul plan, les fabricants les empilent verticalement en couches. Cette approche augmente considérablement la capacité sans réduire la taille des cellules individuelles. Un disque de 2,5 pouces peut désormais contenir plus de 1 To de données. La conception verticale réduit également les interférences électroniques, ce qui améliore la fiabilité par rapport aux anciennes conceptions planaires.Le contrôleur : le cerveau du SSDLes cellules NAND stockent vos données, mais c'est le contrôleur qui gère tout. Ce petit processeur centralise le trafic pour toutes les opérations de stockage SSD. Il communique avec la mémoire vive (RAM) de votre ordinateur et traduit les requêtes en actions physiques sur la mémoire flash.Le contrôleur effectue plusieurs tâches critiques pour maintenir les performances du SSD :Couche de traduction Flash (FTL) : Traduit les adresses de blocs logiques de votre système d'exploitation en emplacements physiques NAND.Nivellement de l'usure : Répartit uniformément les cycles d'écriture/effacement sur tous les blocs afin d'éviter une usure prématurée sur une zone particulière.Collecte des ordures : Consolide les données valides des blocs partiellement remplis et efface les anciens blocs pour récupérer de l'espace pendant les périodes d'inactivité.Code de correction d'erreur (ECC) : Détecte et corrige les erreurs de bits qui surviennent lorsque la mémoire flash se dégrade au fil du temps.Commande TRIM : Informe le disque des blocs de données qui ne sont plus nécessaires, permettant ainsi une collecte efficace des données inutiles.Le contrôleur gère également le transfert de données entre le système hôte et le stockage NAND. Lors de l'enregistrement d'un fichier, le contrôleur reçoit la commande contenant une adresse de bloc logique. Il traduit ensuite cette adresse en un emplacement de page physique. La mémoire NAND ne pouvant écraser les données existantes, le contrôleur alloue un nouvel emplacement pour les données mises à jour et actualise sa table de correspondance. Ce processus s'effectue en quelques millisecondes.L'absence de pièces mobiles dans les disques SSD élimine la latence mécanique. Votre système accède aux données quasi instantanément. Cette conception supprime également le risque de panne mécanique en cas de chute ou de choc. Les contrôleurs modernes planifient même intelligemment les tâches en arrière-plan, garantissant ainsi que le nettoyage de la mémoire n'interfère pas avec vos charges de travail actives. Que vous utilisiez un disque grand public pour les jeux ou un disque professionnel, les performances restent optimales. SSD NVMe d'entreprise comme le Solidigm D7-P5520 Pour les centres de données, le contrôleur garantit des performances constantes, même pour les applications exigeantes comme celles exécutées sur un système de surveillance. NVIDIA GeForce RTX 5090 bénéficier d'un accès rapide à la mémoire flash.SSD SATA : la mise à niveau universelleLes SSD SATA constituent la solution d'accès la plus simple au stockage à semi-conducteurs. Utilisant la même interface que les anciens disques durs, ils sont compatibles avec la quasi-totalité des ordinateurs de bureau et portables fabriqués ces dix dernières années. Leur installation dans un système existant ne nécessite aucun adaptateur ni modification du BIOS. Le format 2,5 pouces se présente sous la forme d'un boîtier rectangulaire fin d'environ 100 mm x 70 mm, pour une épaisseur de seulement 7 mm. Cette forme leur permet de s'insérer dans les baies de disque standard de la plupart des boîtiers d'ordinateurs de bureau.Les performances maximales du SATA III sont théoriquement plafonnées à 600 Mo/s, bien que les vitesses réelles atteignent environ 550 Mo/s en lecture et 520 Mo/s en écriture. Ces chiffres représentent une amélioration considérable par rapport aux disques durs mécaniques. Cependant, l'interface SATA elle-même constitue un goulot d'étranglement. Le protocole a été conçu à l'origine pour les disques durs mécaniques, et non pour la mémoire flash. Cette limitation explique pourquoi les solutions de stockage SSD SATA offrent des gains de performances constants mais modestes par rapport aux alternatives plus récentes.SSD NVMe : Optimiser la vitesse avec PCIeNVMe (Non-Volatile Memory Express) élimine complètement le goulot d'étranglement du SATA. Au lieu de faire transiter les données par un contrôleur SATA, NVMe communique directement avec le processeur via le bus PCIe. Cette différence architecturale réduit la latence des commandes d'environ 6 microsecondes avec AHCI à seulement 2,8 microsecondes avec NVMe. Ce protocole a été conçu spécifiquement pour la mémoire flash, permettant des chemins de données parallèles qui optimisent le débit.Leur conception physique diffère également de manière significative. Les disques M.2 NVMe ressemblent davantage à de petites clés USB qu'à des boîtiers ; ils mesurent 22 mm de large et généralement 80 mm de long, pour une épaisseur de seulement 2 mm. Ce format compact pèse entre 5 et 10 grammes, contre 40 à 60 grammes pour un disque SATA 2,5 pouces. Les ordinateurs portables bénéficient grandement de cette optimisation de l'espace, permettant aux fabricants de concevoir des appareils plus fins sans sacrifier la capacité de stockage SSD.Les performances affichées illustrent clairement l'écart entre les interfaces. Le NVMe sur PCIe 4.0 atteint des vitesses théoriques jusqu'à 8 000 Mo/s, avec des vitesses de lecture réelles comprises entre 7 000 et 7 400 Mo/s. Cela représente environ dix fois la vitesse du SATA III. La dernière génération PCIe 5.0 double la limite théorique à environ 16 000 Mo/s, permettant de gérer des charges de travail exigeantes telles que l'analyse IA et le calcul haute performance. Les joueurs utilisant une NVIDIA GeForce RTX 5090 constateront des temps de chargement de niveaux et un streaming de textures plus rapides avec un disque NVMe. Les centres de données déployant des solutions SSD NVMe d'entreprise telles que le Solidigm D7-P5520 s'appuient sur cette vitesse pour leurs applications critiques.Le choix du type de SSD dépend des emplacements disponibles sur votre carte mère et de vos besoins en performances. Les disques SATA offrent une compatibilité universelle à moindre coût. Les disques NVMe offrent une vitesse inégalée pour ceux qui exigent une réactivité maximale.Disque SSD ou disque dur : lequel est le meilleur ?Lorsqu'on compare un disque SSD à un disque dur traditionnel, les différences sautent aux yeux. La principale distinction réside dans leur conception mécanique. Un disque dur utilise des plateaux rotatifs et une tête de lecture/écriture mobile. Les disques SSD, quant à eux, utilisent des puces de mémoire flash sans aucune pièce mobile. Cette différence fondamentale influence tous les autres points de comparaison.Vitesse, durabilité et bruit : les principales différencesVitesse L'avantage le plus notable des disques SSD réside dans leur rapidité. Sans disque dur rotatif, votre système accède aux données quasi instantanément. Le temps de démarrage passe de plus d'une minute à quelques secondes seulement. Les applications se lancent sans délai. Cette vitesse transforme votre expérience informatique quotidienne. La comparaison SSD/HDD montre que les SSD éliminent la latence mécanique inhérente aux disques plus anciens.Durabilité L'utilisation de la technologie SSD est également privilégiée. En l'absence de pièces mobiles, les SSD résistent bien mieux aux chocs que les disques durs. Les données de fiabilité des disques durs montrent que les SSD présentent des taux de panne inférieurs. Backblaze a évalué 284 386 disques au deuxième trimestre 2024 et a constaté un taux de panne annuel moyen de 1,71 % pour les disques durs. Une étude de Schroeder & Gibson a rapporté un taux de remplacement annuel pondéré global de 3,01 % pour les disques durs. Les taux de panne varient de 0,5 % à 13,5 % selon l'âge du disque. Les fiches techniques des fabricants indiquent un taux de panne annuel typique pour les SSD compris entre 0,58 % et 0,88 %. Les clés USB ont des taux de remplacement nettement inférieurs à ceux des disques durs traditionnels, bien qu'elles puissent présenter des taux d'erreurs non corrigibles plus élevés. Les solutions de stockage SSD offrent une meilleure fiabilité pour vos données sur le long terme.Bruit C'est un autre domaine où les SSD excellent. Un SSD ne produit aucun décibel, quelles que soient les conditions de fonctionnement. Un disque dur génère du bruit grâce à la rotation de ses plateaux et de sa tête de lecture/écriture.Type de stockageNiveau sonore (dB)Conditions de fonctionnementDisque dur (Entreprise, SAS 600 Go)30–35Fonctionnement normalDisque dur (Entreprise, SAS 600 Go)40–45Charge lourdeSSD (modèles SATA/SAS)0 (silencieux)Toutes les conditionsCe silence contribue à un environnement informatique plus agréable.Les avantages et les inconvénients du changementLes avantages des disques SSD sont indéniables. Ils offrent un démarrage plus rapide, un fonctionnement plus silencieux, une meilleure durabilité et une consommation d'énergie réduite. L'absence de pièces mobiles diminue la chaleur dégagée, ce qui est bénéfique pour les ordinateurs portables. L'efficacité énergétique est un autre atout : les SSD consomment moins d'énergie que les disques durs, ce qui prolonge l'autonomie des ordinateurs portables. Cette combinaison d'avantages fait des disques SSD le choix privilégié pour les ordinateurs modernes. Pour les applications exigeantes, comme les jeux sur une carte graphique haut de gamme telle que la NVIDIA GeForce RTX 5090, un SSD garantit un chargement rapide des textures. Les entreprises bénéficient de solutions SSD NVMe professionnelles, comme le Solidigm D7-P5520, qui offrent des performances constantes pour les charges de travail gourmandes en données.Le principal inconvénient demeure le coût. La comparaison des prix des disques durs et des SSD révèle que ces derniers restent plus chers au gigaoctet que les disques durs. Le tableau ci-dessous présente les prix actuels.CapacitéCoût d'un SSD NVMePrix ​​d'un SSD 2,5 poucesCoût du disque dur1 To38,99 $34,99 $26,99 $2 To69,98 $68,98 $35,99 $4 To199,99 $179,99 $49,64 $8 To899,99 $499,00 $99,99 $16 TB-2499,99 $224,99 $L'écart de prix entre SSD et HDD s'est réduit au fil des ans, mais il subsiste. À 4 To, un SSD coûte environ quatre fois plus cher qu'un HDD. La durée de vie est un autre facteur important. La plupart des SSD modernes durent de 5 à 10 ans en utilisation quotidienne normale, dépassant souvent la période de garantie standard. L'endurance en écriture est cruciale pour les utilisateurs intensifs. Les SSD modernes gèrent ce facteur grâce à l'équilibrage d'usure, assurant ainsi une longue durée de vie au disque. Pour votre stockage principal, cette longévité justifie pleinement l'investissement.Pour la plupart des utilisateurs, les avantages des disques SSD compensent largement leur prix plus élevé. Le gain de performance à lui seul justifie l'investissement. Le choix d'un disque dur SSD dépendra en fin de compte de votre budget et de vos besoins de stockage. Associez un SSD à des disques durs traditionnels pour un stockage de masse si vous avez besoin à la fois de vitesse et de capacité. La polyvalence d'un SSD le rend adapté aussi bien à une utilisation quotidienne qu'aux applications professionnelles.Guide pratique : Mise à niveau vers un disque SSDComment choisir le SSD adapté à vos besoinsVotre utilisation principale détermine le SSD le mieux adapté à votre flux de travail. Les joueurs qui utilisent une carte graphique haut de gamme comme la NVIDIA GeForce RTX 5090 ont besoin d'un SSD NVMe offrant des vitesses de lecture aléatoire rapides. Les créateurs de contenu ont des besoins différents. Dans les configurations avancées, il leur faut des disques distincts pour leur système, leurs projets en cours et les fichiers cache. Une configuration à disque unique impose des compromis qui ralentissent le montage.FacteurConsidération cléConseils pratiquesType de lecteurLes disques système privilégient une faible latence ; les disques de projet nécessitent des vitesses soutenues et de la mémoire DRAM.Utilisez des SSD distincts pour le système, les projets et le cache dans les configurations avancées.Capacité et TBWUne capacité plus élevée permet un meilleur coût par téraoctet et une capacité totale de stockage d'eau plus élevée.Choisissez au moins 1 à 2 To pour un bon rapport qualité-prix ; les disques de plus grande capacité durent plus longtemps en cas d’écritures intensives.Cache DRAMLes disques équipés de mémoire DRAM évitent les ralentissements lors des écritures prolongées.Privilégiez la mémoire DRAM pour les disques de projet ; les options non-DRAM peuvent suffire pour les disques de cache.Vitesse réelleLes vitesses séquentielles annoncées sont rarement maintenues ; les opérations de lecture/écriture aléatoires sont plus importantes.Vérifiez les performances avec des logiciels de benchmark comme PCMark 10 ; attendez-vous à des débits de transfert réels d'environ 2 500 à 3 000 Mo/s.Les monteurs indépendants travaillant sur des projets de petite envergure ont besoin d'une solution de stockage SSD d'au moins 1 To. Les petites équipes collaborant efficacement bénéficient d'un NAS centralisé d'une capacité de 4 à 8 To. Les équipes plus importantes travaillant sur la vidéo haute définition nécessitent un stockage partagé d'au moins 20 To. Les studios professionnels produisant du contenu 4K/8K devraient investir dans une infrastructure SAN de plus de 50 To pour des performances optimales et une capacité d'extension future. La résolution de votre projet, le nombre d'utilisateurs simultanés et vos besoins en matière de sauvegarde sont autant d'éléments à prendre en compte dans ce choix.Les charges de travail en entreprise exigent des considérations différentes. Un SSD NVMe professionnel comme le Solidigm D7-P5520 offre des performances de stockage SSD constantes pour les centres de données exécutant des applications d'analyse d'IA ou de bases de données. Ces disques offrent une endurance supérieure et des fonctionnalités de protection contre les coupures de courant dont sont dépourvus les modèles grand public.Installation et longévité : Conseils pour un disque dur sainDeux options s'offrent à vous lors de la mise à niveau depuis un disque dur vers un SSD. Le clonage consiste à copier l'intégralité de votre système d'exploitation et de vos fichiers sur le nouveau SSD. L'installation propre, quant à elle, vous permet de repartir de zéro, en éliminant les fichiers inutiles accumulés. La plupart des utilisateurs privilégient le clonage pour sa simplicité, mais une installation propre offre généralement de meilleures performances SSD à long terme.La commande TRIM joue un rôle essentiel dans la préservation de la santé de votre disque. Cette instruction du système d'exploitation indique à votre SSD quels blocs de données ne sont plus nécessaires après la suppression d'un fichier. Votre disque efface alors proactivement ces blocs et les prépare pour de futures écritures. Ce processus réduit l'amplification d'écriture et les cycles d'effacement inutiles. En minimisant les déplacements de données internes, TRIM diminue l'usure des cellules de mémoire flash et prolonge la durée de vie de votre disque.Il est également conseillé de mettre à jour régulièrement le firmware de votre disque à l'aide des outils du fabricant. Activez la fonction TRIM dans les paramètres de votre système d'exploitation pour garantir la maintenance automatique. Évitez de retirer l'étiquette de votre disque, car cela pourrait annuler votre garantie. Effectuez périodiquement des tests de performance pour vérifier que votre SSD conserve les vitesses attendues. Ces simples pratiques vous permettront de conserver un disque SSD performant pendant des années. L'amélioration du temps de démarrage et du chargement des applications constatée après l'installation transformera votre utilisation quotidienne de l'informatique.La conception à semi-conducteurs révolutionne votre expérience informatique. L'absence de pièces mobiles garantit un démarrage plus rapide, un fonctionnement plus silencieux et une durabilité accrue. Votre SSD vous offre un accès instantané aux données, que vous jouiez sur une NVIDIA GeForce RTX 5090 ou que vous gériez des charges de travail d'entreprise avec un SSD NVMe Solidigm D7-P5520.En 2026, le stockage SSD sera la norme, et non plus une option. Le marché reflète cette évolution. Le chiffre d'affaires des SSD pour entreprises progressera régulièrement, passant de 8,5 milliards de dollars en 2024 à 21,5 milliards de dollars en 2033, soit un taux de croissance annuel composé de 12,3 %. Cette catégorie de stockage informatique domine désormais les nouvelles configurations de systèmes.La technologie de stockage évolue sans cesse. Des interfaces plus rapides et une mémoire plus dense font leur apparition chaque année. Si vous utilisez encore un disque dur mécanique, passez à la vitesse supérieure dès maintenant. Vous apprécierez la différence plus tard.FAQQuelle est la durée de vie réelle d'un SSD ?Les disques SSD modernes ont une durée de vie de 5 à 10 ans en utilisation quotidienne normale. L'équilibrage de l'usure répartit uniformément les cycles d'écriture sur toutes les cellules. Cette technologie empêche toute usure prématurée d'une zone spécifique. La plupart des disques durent bien au-delà de leur période de garantie sans problème.Puis-je installer un SSD dans mon ancien ordinateur ?Oui, vous pouvez mettre à niveau la quasi-totalité des ordinateurs de bureau et portables des dix dernières années. Les SSD SATA utilisent la même interface que les disques durs traditionnels. Votre système reconnaîtra le disque sans adaptateur spécifique ni modification du BIOS. Cette compatibilité fait des SSD la solution d'amélioration de performances la plus simple.Un SSD améliorera-t-il mon expérience de jeu ??Absolument. Les jeux chargent les niveaux plus rapidement et les textures s'affichent sans saccades. Associer un SSD à une carte graphique puissante comme la NVIDIA GeForce RTX 5090 élimine les problèmes de stockage. Vous constaterez des temps de chargement plus courts et une exploration du monde ouvert plus fluide.Qu'est-ce qui différencie les disques SSD NVMe pour entreprises des modèles grand public ?Les disques pour entreprises, comme le Solidigm D7-P5520, offrent une endurance supérieure et une protection contre les coupures de courant. Ils garantissent des performances constantes même sous des charges de travail importantes et continues. Les disques grand public privilégient le rapport coût-efficacité pour les tâches quotidiennes. Les centres de données, quant à eux, exigent la fiabilité des solutions SSD NVMe pour entreprises.
  • NVIDIA SN5600 ou Cisco 800GbE : Comparaison complète pour les centres de données modernes
    NVIDIA SN5600 ou Cisco 800GbE : Comparaison complète pour les centres de données modernes
    August 27, 2026
    Choisir entre les NVIDIA Spectrum-4 SN5600 Le Cisco Nexus G200 structure l'ensemble de votre stratégie réseau d'IA. Il vous faut un commutateur capable de gérer un trafic GPU massif sans goulots d'étranglement. La plateforme NVIDIA s'intègre parfaitement à Spectrum-X et BlueField-3, créant une infrastructure étroitement couplée pour le calcul accéléré. Cisco, quant à lui, mise sur la flexibilité multi-fournisseurs et la conformité UEC, des atouts majeurs pour les environnements hétérogènes. L'avenir de votre centre de données repose sur cette décision. L'infrastructure NVIDIA excelle en matière d'Ethernet sans perte et de routage adaptatif, minimisant la latence de queue pour l'entraînement distribué. La force de Cisco réside dans son interopérabilité basée sur des normes, vous permettant de combiner des équipements de différents fournisseurs. Vous devez trouver un équilibre entre le risque de dépendance à un écosystème et la liberté opérationnelle.Tenez compte de l'envergure de vos charges de travail d'IA et de votre tolérance aux optimisations spécifiques à chaque fournisseur. Ce comparatif vous aidera à évaluer les deux plateformes en fonction de vos besoins spécifiques. Points clés à retenirChoisissez le NVIDIA SN5600 pour une intégration étroite de l'écosystème IA avec DGX et BlueField-3, offrant des performances et une automatisation supérieures.Choisissez Cisco Nexus G200 pour sa flexibilité multi-fournisseurs et sa conformité UEC, idéal pour les environnements hétérogènes et réglementés.Les deux commutateurs offrent un débit de 51,2 Tbit/s, mais NVIDIA excelle dans l'Ethernet sans perte et le routage adaptatif, tandis que Cisco propose une ingénierie du trafic granulaire.Évaluez l'ampleur de votre charge de travail, votre engagement envers l'écosystème et vos besoins de conformité afin d'aligner votre choix sur vos objectifs d'infrastructure à long terme.Effectuez un test de faisabilité avec vos charges de travail réelles afin de valider les performances et l'adéquation opérationnelle avant de vous engager. Présentation des plateformes : SN5600 vs. Cisco Nexus G200Avant d'évaluer les indicateurs de performance, il est essentiel de comprendre les principes fondamentaux de chaque plateforme. Le NVIDIA Spectrum-4 SN5600 et le Cisco Nexus G200 incarnent deux philosophies distinctes pour les réseaux 800GbE. Votre choix entre ces deux solutions déterminera l'ensemble de votre stratégie d'infrastructure d'IA.À l'intérieur du NVIDIA Spectrum-4 SN5600 : ASIC et tamponLe commutateur NVIDIA Spectrum-4 SN5600 repose sur un ASIC dédié offrant un débit exceptionnel pour les charges de travail d'IA. Ce commutateur fournit une bande passante bidirectionnelle de 51,2 Tbit/s, garantissant un débit élevé et une faible latence. Ces performances sont obtenues grâce à une conception SerDes optimisée.Le circuit intégré spécifique Spectrum-4 utilise des voies SerDes de 100 Gb/s, obtenues grâce à une signalisation native de 50 Gb/s avec un codage PAM-4 (2 bits par signal).Ces voies se regroupent par 8 pour former un seul port 800 GbE.Avec 64 ports de ce type, le débit agrégé est calculé comme suit : 64 ports × 800 Gb/s = 51,2 Tb/s.Cette configuration cible spécifiquement les interconnexions de centres de données régionaux, où les ports 800 GbE sont l'élément clé.Au-delà de sa vitesse brute, le SN5600 est doté d'une architecture de mémoire tampon de paquets dynamique entièrement partagée. Cette conception absorbe efficacement les micro-rafales, garantissant une latence faible et prévisible lors de l'entraînement distribué. Vous bénéficiez également d'une prise en charge native de RoCE et d'une optimisation pour NVIDIA Spectrum-X Ethernet, créant ainsi une infrastructure étroitement intégrée pour les clusters de GPU. Le commutateur traite jusqu'à 33,3 milliards de paquets par seconde, assurant l'absence de perte de paquets même sous une charge soutenue. Cisco Nexus G200 : Préparation Silicon One et UECLe Cisco Nexus G200 adopte une approche différente grâce à son ASIC Silicon One G200. Ce commutateur privilégie l'interopérabilité multi-fournisseurs et la conformité aux normes. Vous bénéficiez ainsi de configurations de ports flexibles qui s'adaptent à divers environnements réseau.SpécificationValeurdébit51,2 Tbit/s (duplex intégral)Configuration des ports64x800GE à 512x100GECisco positionne cette plateforme pour une compatibilité UEC optimale, permettant son intégration dans des infrastructures hétérogènes sans dépendance à un système propriétaire. L'architecture Silicon One prend en charge l'ingénierie avancée du trafic, offrant un contrôle précis des flux de données. Pour les environnements soumis à des exigences de conformité strictes, la gamme Cisco Nexus propose une gestion NX-OS familière, réduisant ainsi les coûts d'exploitation. Votre décision dépend des priorités de votre écosystème. La plateforme NVIDIA excelle si vous optez pour l'intégration de NVIDIA Spectrum-X Ethernet et BlueField-3. Cisco est plus avantageux si vous recherchez la flexibilité avec plusieurs fournisseurs. Les deux commutateurs offrent un débit de 51,2 Tbit/s, mais leurs points forts diffèrent : l'optimisation de l'infrastructure IA par rapport à l'adaptabilité aux normes. Comparaison des spécifications côte à côtePour évaluer ces plateformes, il vous faut des chiffres précis. Les deux commutateurs offrent un débit de 51,2 Tbit/s en mode duplex intégral, mais leurs choix architecturaux diffèrent considérablement. Le tableau ci-dessous récapitule les spécifications essentielles à prendre en compte.SpécificationNVIDIA Spectrum-4 SN5600Cisco Nexus G200ASICSpectre-4Silicon One G200débit51,2 Tbit/s51,2 Tbit/sDensité portuaire64x800GbE à 512x100GbE64x800GE à 512x100GETraitement des paquets33,3 BppsDébit de ligne comparableArchitecture de tamponTampon de paquets dynamique entièrement partagéTampon partagé configurableSystème d'exploitation de gestionSystème d'exploitation Cumulus Linux / NVIDIANX-OS Statistiques de performance : débit de ligne, ports et latenceLe routeur NVIDIA Spectrum-4 SN5600 atteint un débit réel de 800 Gbit/s sur l'ensemble de ses 64 ports simultanément. Cette performance est obtenue grâce à des voies SerDes 100 Gbit/s utilisant le codage PAM-4. Chaque port regroupe huit voies pour former une connexion 800 GbE unique. Cette configuration est idéale pour les interconnexions de centres de données régionaux où la haute densité de ports 800 GbE élimine les goulots d'étranglement. Le Silicon One G200 de Cisco offre un débit équivalent avec une densité de ports identique. Sa configuration est flexible et permet de configurer jusqu'à 64 ports (800GE) ou 512 ports (100GE), s'adaptant ainsi à diverses topologies de réseau. Les deux plateformes traitent les paquets à pleine vitesse sans perte de trames, même en cas de charge soutenue. La latence différencie subtilement ces commutateurs. La plateforme NVIDIA garantit une latence faible et prévisible grâce à sa conception de mémoire tampon dynamique. Vous bénéficiez ainsi d'un transfert de paquets constant, même lors de micro-rafales. Cisco atteint des niveaux de latence comparables grâce à son architecture Silicon One, bien que sa stratégie de gestion de la mémoire tampon diffère. Le choix de la solution la plus adaptée dépendra de votre charge de travail. Contrôle de la congestion et routage adaptatifLes charges de travail liées à l'IA génèrent des schémas de trafic uniques qui saturent les mécanismes de contrôle de congestion traditionnels. Une gestion intelligente de l'infrastructure est indispensable pour maintenir le débit lors des entraînements distribués. Les deux fournisseurs abordent ce problème différemment.NVIDIA intègre le routage adaptatif directement dans le circuit intégré spécifique (ASIC) Spectrum-4. Cette fonctionnalité redirige dynamiquement le trafic en contournant les chemins congestionnés, sans intervention du processeur. Vous bénéficiez ainsi d'une sélection automatique des chemins qui s'adapte en temps réel à l'état du réseau. Le commutateur associe cette capacité à la prise en charge native de RoCEv2, permettant un Ethernet sans perte pour le trafic RDMA. L'approche de NVIDIA minimise la latence de queue en prévenant la formation de points chauds. Cisco s'appuie sur des mécanismes de contrôle de congestion standardisés, principalement DCQCN (Data Center Quantized Congestion Notification). Vous configurez des seuils de notification de congestion explicites pour gérer l'occupation des tampons. Le circuit intégré spécifique Silicon One prend en charge l'ingénierie du trafic avancée, vous offrant un contrôle précis du placement des flux. Cette approche standardisée garantit l'interopérabilité avec les commutateurs tiers de votre infrastructure. L'expérience de gestion diffère considérablement d'une plateforme à l'autre. NVIDIA propose Cumulus Linux, offrant un environnement d'exploitation Linux familier. La migration s'automatise grâce aux outils DevOps standard. Cisco NX-OS fournit l'interface en ligne de commande que les ingénieurs réseau connaissent déjà. Le niveau de familiarité de votre équipe avec les outils opérationnels utilisés devrait guider votre choix. Pour l'optimisation des infrastructures réseau basées sur l'IA, le routage adaptatif de NVIDIA offre un avantage indéniable. Le commutateur répartit automatiquement le trafic sur les chemins disponibles, réduisant ainsi les pertes de paquets dues à la congestion. L'approche de Cisco exige un paramétrage manuel plus poussé, mais offre un contrôle accru pour les environnements spécialisés. Il vous appartient d'évaluer si l'automatisation ou un contrôle précis correspond à votre modèle opérationnel. L'architecture du tampon constitue une autre distinction cruciale. Le tampon dynamique entièrement partagé de NVIDIA absorbe efficacement les micro-rafales, garantissant des performances constantes même en cas de pics de trafic liés à l'IA. Le tampon configurable de Cisco permet d'allouer des ressources en fonction du profil de trafic. Ces deux approches préviennent la perte de paquets, mais par des mécanismes différents. Votre choix dépendra en définitive de la complexité de votre infrastructure et de l'expertise de votre équipe. La plateforme NVIDIA excelle dans les environnements d'IA étroitement intégrés où l'automatisation est essentielle. La flexibilité de Cisco convient aux réseaux hétérogènes nécessitant une optimisation manuelle. Fonctionnalités de performance et d'IA de Fabric Optimisations Ethernet sans perte et RDMAVotre cluster d'IA exige une connexion Ethernet sans perte pour protéger le trafic RDMA contre les pertes de paquets. Le NVIDIA SN5600 prend en charge nativement RoCEv2 grâce à une mémoire tampon de paquets dynamique entièrement partagée. Cette architecture absorbe les micro-rafales au niveau du commutateur, empêchant ainsi la propagation de la congestion sur votre infrastructure. Vous maintenez une latence prévisible, même en cas de forte augmentation de la charge. plusieurs GPU Les nœuds explosent simultanément lors des points de contrôle d'entraînement. Cisco garantit un transport sans perte grâce aux protocoles Data Center Bridging. Le contrôle de flux prioritaire (PFC) envoie des trames de pause pour gérer les flux Ethernet, tandis que la notification explicite de congestion (ECN) signale les paquets congestionnés sans les abandonner. Cette approche standardisée assure l'interopérabilité avec les commutateurs tiers de votre réseau. Vous configurez ces mécanismes via NX-OS, en ajustant les seuils en fonction de votre profil de charge. La plateforme NVIDIA minimise la latence de queue grâce à son allocation dynamique de mémoire tampon. Lorsqu'un port subit un pic de trafic, le commutateur redistribue automatiquement la capacité de la mémoire tampon à partir des ports inactifs. Vos tâches d'entraînement distribuées évitent ainsi l'effet de traînée qui ralentit le temps d'itération global. La mémoire tampon configurable de Cisco nécessite un réglage manuel, mais offre un contrôle précis pour les modèles de trafic spécifiques. Ingénierie du trafic pour les charges de travail d'IAL'interface Ethernet NVIDIA Spectrum-X intègre le routage adaptatif directement dans le circuit intégré spécifique (ASIC). Le commutateur redirige le trafic en contournant les chemins congestionnés sans intervention du processeur, en s'adaptant en temps réel aux conditions du réseau. Vous bénéficiez ainsi d'une sélection automatique des chemins, évitant la formation de points chauds. Cette fonctionnalité s'avère essentielle pour votre infrastructure d'IA, où les schémas de trafic évoluent de manière imprévisible sur des milliers de connexions GPU. Cisco intègre Intelligent Packet Flow, une suite complète d'ingénierie du trafic. Le Silicon One G200 prend en charge l'équilibrage de charge dynamique (basé sur les flowlets) qui répartit le trafic en fonction des données télémétriques d'utilisation des liens. Vous bénéficiez également d'un équilibrage de charge par paquet, qui répartit les paquets sur plusieurs chemins pour un débit maximal. La technologie WCMP (Weighted Cost Multipath) permet une pondération intelligente des chemins pour les topologies asymétriques. L'équilibrage de charge basé sur des politiques attribue des stratégies spécifiques aux charges de travail mixtes en fonction des listes de contrôle d'accès (ACL), des marquages ​​DHCP ou des en-têtes RoCEv2. La visibilité est un élément distinctif de ces plateformes d'analyse des charges de travail d'IA. Cisco fournit une télémétrie matérielle des flux qui comptabilise chaque paquet traversant le commutateur, y compris les micro-rafales et les pertes. Les compteurs ECN signalent la congestion par périphérique, par interface et au niveau du flux via Nexus Dashboard Insights. Les statistiques de paquets PFC révèlent les trames de pause émises par classe de service, permettant un réglage de la congestion en temps réel. Les compteurs NVIDIA, associés à la télémétrie intégrée de Spectrum-4, offrent une visibilité complète sur l'ensemble du réseau via le plan de gestion Spectrum-X. Votre infrastructure d'IA tire parti des deux approches. Le routage adaptatif de NVIDIA réduit les interventions manuelles, idéal pour l'entraînement d'IA à grande échelle où l'automatisation est essentielle. Les contrôles basés sur des politiques de Cisco conviennent aux environnements hétérogènes exigeant une gestion précise du trafic. Le commutateur que vous choisissez détermine le niveau de contrôle que vous exercez sur les flux de données de votre cluster d'IA. Scénarios d'utilisation : quand choisir chaque option ?Les caractéristiques de votre charge de travail déterminent la plateforme la plus adaptée à vos besoins. Le NVIDIA SN5600 excelle dans les environnements d'IA étroitement intégrés, tandis que le Cisco Nexus G200 est idéal pour les réseaux hétérogènes soumis à des contraintes de conformité. Comprendre ces scénarios vous permet d'aligner vos investissements en infrastructure sur votre réalité opérationnelle. NVIDIA SN5600 pour un écosystème NVIDIA restreint (DGX, BlueField)Vous exploitez une infrastructure d'IA centrée sur NVIDIA lorsque vos nœuds de calcul, votre stockage et votre réseau forment une pile unifiée. Le commutateur NVIDIA Spectrum-4 SN5600 s'intègre parfaitement aux architectures DGX SuperPOD, fournissant la bande passante requise par vos clusters de GPU. NVIDIA conçoit ce commutateur spécifiquement pour les réseaux Ethernet Spectrum-X, créant ainsi un environnement cohérent où chaque composant communique de manière optimale. L'architecture de référence DGX SuperPOD illustre parfaitement cette intégration. Vous pouvez faire évoluer votre environnement d'entraînement IA de 2 304 à 9 216 GPU répartis sur 16 unités évolutives (SU). Chaque SU associe deux commutateurs SN5600 en tant que couche dorsale, agrégeant les commutateurs de périphérie qui font face aux plateaux de calcul et de stockage DGX. Pour les déploiements plus importants, vous ajoutez une couche dorsale supplémentaire à deux groupes, garantissant ainsi un fonctionnement non bloquant sur l'ensemble de votre infrastructure.Échelle (GPU)Échelle (SU)Super Groupes de Colonne VertébraleSuper épines par groupeInterrupteurs Super Spine TotalInterrupteurs de colonne vertébrale totale2304422464460882481289216162714256921616624144512 L'intégration du DPU BlueField-3 optimise encore davantage les performances de votre cluster d'IA. La version DOCA 2.7 active l'architecture de référence Spectrum-X 1.0.1, testée spécifiquement pour les SuperNIC BlueField associées aux commutateurs SN5600. Cette architecture offre une connectivité Ethernet sans perte grâce au routage adaptatif et au contrôle de congestion programmable par DOCA. Les SuperNIC BlueField, livrées en mode carte réseau par défaut, prennent en charge GPUDirect RDMA, simplifiant ainsi le déploiement. Les résultats des tests de performance démontrent l'impact concret. Une tâche d'optimisation fine s'exécute en 1 heure et 40 minutes avec GPUDirect RDMA, en utilisant SN5600 et BlueField-3. La même tâche prend 2 heures et 30 minutes avec TCP/Socket sur Ethernet Spectrum-4, et 5 heures avec un réseau OVN par défaut. Vous obtenez ainsi une amélioration de 3x par rapport à la configuration de base, accélérant directement vos cycles d'entraînement d'IA. Cisco Nexus G200 pour les environnements multi-fournisseurs et FedRAMPLe Cisco Nexus G200 est le choix idéal lorsque votre centre de données s'appuie sur des équipements de différents fournisseurs et que les exigences de conformité sont un facteur déterminant. Ce commutateur prend en charge les normes UEC, vous permettant d'intégrer des équipements de divers fabricants sans contraintes propriétaires. Votre réseau reste ainsi ouvert et adaptable à l'évolution des normes. La plateforme Cisco Nexus excelle dans les environnements où il est impossible de se limiter à un seul écosystème. Elle permet de combiner des commutateurs de différents fournisseurs, tout en préservant la flexibilité opérationnelle de votre infrastructure. La gestion NX-OS offre des outils familiers à votre équipe d'ingénierie réseau, réduisant ainsi les coûts de formation et les risques opérationnels. La conformité FedRAMP constitue un atout majeur pour les secteurs public et privé réglementés. Le cadre de conformité éprouvé de Cisco simplifie votre processus de certification. Vous pouvez déployer le G200 dans des environnements exigeant des contrôles de sécurité stricts, en ayant l'assurance que la plateforme répond aux normes fédérales les plus rigoureuses. Cette capacité s'avère essentielle pour les contrats du secteur public et les charges de travail commerciales réglementées. Votre infrastructure d'IA bénéficie de l'ingénierie du trafic basée sur des politiques de Cisco. Vous configurez des stratégies d'équilibrage de charge adaptées à vos modèles de charge de travail spécifiques, que vous exécutiez des entraînements ou des inférences distribués à grande échelle. Le circuit intégré spécifique Silicon One G200 offre un contrôle précis des flux de données, permettant une gestion optimale des ressources de votre cluster d'IA. La décision finale repose sur votre stratégie écosystémique. Choisissez NVIDIA Lorsque vous optez pour une architecture d'IA étroitement intégrée avec les composants DGX et BlueField, choisissez Cisco si vous avez besoin de flexibilité multi-fournisseurs, de conformité UEC et de certifications réglementaires reconnues. L'architecture de votre infrastructure d'IA doit refléter la vision à long terme de votre organisation. Cadre de décision et liste de contrôleCritères de sélection clés : échelle, écosystème et normesVotre évaluation commence par l'échelle de la charge de travail. Le NVIDIA SN5600 excelle pour les environnements d'entraînement d'IA à grande échelle comportant des milliers de GPU. Le Cisco Nexus G200, quant à lui, est adapté aux infrastructures hétérogènes où l'interopérabilité entre différents fournisseurs prime sur une intégration étroite. Il est essentiel d'évaluer objectivement la croissance de votre cluster d'IA avant de choisir l'une ou l'autre plateforme. L'engagement envers l'écosystème influence considérablement votre décision. La plateforme Nvidia offre une valeur maximale lorsqu'elle est associée aux systèmes DGX et aux DPU BlueField-3. Cette intégration crée une infrastructure d'IA cohérente avec une optimisation automatisée. L'alternative Cisco Nexus offre une liberté opérationnelle, vous permettant de combiner des commutateurs de différents fabricants sans contraintes propriétaires. Votre tolérance à la dépendance vis-à-vis d'un fournisseur détermine l'approche la plus adaptée à votre stratégie d'infrastructure. La conformité aux normes influence la viabilité à long terme. Cisco positionne le G200 pour la conformité UEC, assurant ainsi la pérennité de votre réseau face à l'évolution des normes industrielles. NVIDIA se concentre sur l'optimisation Spectrum-X, offrant des performances supérieures dès aujourd'hui grâce à des améliorations propriétaires. Il est essentiel de comparer les avantages immédiats de l'analyse des charges de travail IA aux exigences d'interopérabilité futures. Liste de contrôle pratique pour les architectes de centres de donnéesConsultez cette liste de vérification avant de choisir votre plateforme de commutation 800GbE :Documentez vos principaux types de charge de travail : entraînement distribué, inférence ou trafic d’entreprise mixte.Calculez la bande passante requise par rack et la capacité totale de votre infrastructure.Évaluez la familiarité opérationnelle de votre équipe avec Cumulus Linux par rapport à NX-OS.Évaluez votre tolérance aux optimisations spécifiques aux fournisseurs par rapport aux normes ouvertes.Vérifier les exigences de conformité, notamment FedRAMP pour les contrats gouvernementaux.Projetez la croissance de votre cluster d'IA sur les trois à cinq prochaines années.Testez les deux plateformes dans le cadre d'une preuve de concept avec vos modèles de charge de travail réels.Votre infrastructure compatible avec l'IA dépend de l'adéquation des capacités de commutation à la réalité opérationnelle. La plateforme Nvidia offre des performances supérieures pour les environnements d'IA dédiés. Le commutateur Cisco assure la flexibilité nécessaire aux divers écosystèmes de centres de données. Réalisez des tests de performance contrôlés mesurant le débit, la latence et le comportement en cas de congestion, en fonction de vos profils de trafic spécifiques. Cette décision repose sur un équilibre entre les besoins de performance immédiats et la flexibilité architecturale à long terme. L'architecture de votre centre de données doit refléter la stratégie de votre organisation. Choisissez la plateforme qui répond aux exigences actuelles de votre cluster d'IA tout en anticipant sa croissance future. Le choix de votre infrastructure IA dépend de votre stratégie d'écosystème. La plateforme NVIDIA excelle dans les infrastructures IA étroitement intégrées grâce à une gestion RDMA native et une gestion des tampons supérieures. Vos charges de travail IA bénéficient de l'allocation dynamique de tampons de l'ASIC NVIDIA Spectrum-4. Le commutateur NVIDIA minimise la latence de queue pour l'entraînement distribué. L'alternative Cisco Nexus offre une plus grande flexibilité dans les environnements multi-fournisseurs. Votre réseau reste ouvert grâce à la conformité UEC intégrée au commutateur Cisco. Vous devez évaluer les exigences de votre centre de données au regard des atouts de chaque plateforme. L'infrastructure IA la plus adaptée dépend de votre échelle, de votre écosystème et de vos exigences de conformité. Évaluez les caractéristiques de vos charges de travail IA et réalisez une preuve de concept pour valider votre choix. Votre infrastructure NVIDIA offre des performances optimales pour les clusters IA dédiés. Votre réseau Cisco prend en charge les environnements hétérogènes avec des flux de données diversifiés. Pour les environnements centrés sur NVIDIA, ce choix d'infrastructure garantit des performances optimales pour votre infrastructure IA. FAQQuelle plateforme offre les meilleures performances pour les charges de travail d'entraînement d'IA ?Le contrôleur NVIDIA SN5600 excelle dans les environnements d'IA dédiés grâce à l'optimisation Spectrum-X et au routage adaptatif. Sa mémoire tampon dynamique absorbe efficacement les micro-rafales, minimisant ainsi la latence de queue lors de l'entraînement distribué. Cisco offre un débit comparable, mais nécessite un paramétrage manuel plus poussé pour les modèles de trafic spécifiques à l'IA. Le choix de la solution la plus adaptée dépendra de l'échelle de votre charge de travail.Puis-je intégrer l'un ou l'autre de ces commutateurs dans un réseau multi-fournisseurs existant ?Le Cisco Nexus G200 offre une flexibilité optimale pour les environnements hétérogènes. Sa conformité UEC et son contrôle de congestion basé sur les normes assurent une interopérabilité parfaite avec les équipements tiers. Le commutateur NVIDIA s'intègre de manière optimale au sein d'un écosystème NVIDIA complet. Votre tolérance au risque de dépendance vis-à-vis d'un fournisseur unique devrait guider votre choix.À quel type d'expérience en matière de gestion puis-je m'attendre de chaque commutateur ?NVIDIA propose Cumulus Linux, offrant un environnement d'exploitation Linux familier. La migration s'automatise grâce aux outils DevOps standard. Cisco fournit NX-OS avec l'interface en ligne de commande que les ingénieurs réseau connaissent déjà. La familiarité de votre équipe avec l'une ou l'autre plateforme réduit les coûts de formation et les risques opérationnels.Comment ces commutateurs gèrent-ils différemment le contrôle de la congestion ?NVIDIA implémente le routage adaptatif directement dans l'ASIC Spectrum-4, réacheminant dynamiquement le trafic pour contourner les chemins congestionnés sans intervention du processeur. Cisco s'appuie sur DCQCN et des seuils de notification de congestion explicites. Vous configurez ces mécanismes via NX-OS, en ajustant les paramètres à votre profil de charge de travail et à la topologie de votre infrastructure.Quel commutateur prend le mieux en charge l'évolution future des normes ?Cisco positionne le Nexus G200 comme solution compatible avec l'UEC, assurant ainsi la pérennité de votre réseau à mesure que les normes industrielles évoluent. NVIDIA, quant à elle, mise sur l'optimisation Spectrum-X, offrant des performances supérieures dès aujourd'hui grâce à des améliorations propriétaires. Votre vision à long terme de l'infrastructure déterminera l'approche la plus adaptée à votre stratégie d'architecture de centre de données.
  • Test du Seagate Exos X18 12 To : caractéristiques, performances et cas d’utilisation en entreprise
    Test du Seagate Exos X18 12 To : caractéristiques, performances et cas d’utilisation en entreprise
    August 23, 2026
    Test du Seagate Exos X18 12 To : caractéristiques, performances et cas d’utilisation en entreprisePour choisir un disque dur destiné à un serveur, une baie RAID, un centre de données ou un système de stockage à grande échelle, la capacité seule ne doit pas être le seul critère. Il est également essentiel de prendre en compte la compatibilité des interfaces, les performances soutenues, les exigences en matière de charge de travail, la technologie d'enregistrement, la fiabilité et le comportement du disque tout au long de sa durée de vie.  Le Seagate Exos X18 12 To Ce disque est conçu précisément pour ce type d'environnement. Dans ce test, vous découvrirez ses caractéristiques, les performances théoriques du modèle SATA ST12000NM000J, son intégration dans une architecture de stockage d'entreprise et les situations où il est préférable de le choisir plutôt qu'un disque dur grand public ou destiné à un NAS. Le Seagate Exos X18 12 To ST12000NM000J est un disque dur SATA 3,5 pouces destiné aux entreprises. Il offre une capacité de 12 To, une vitesse de rotation de 7 200 tr/min, 256 Mo de cache, l'enregistrement CMR, une construction étanche à l'hélium et une interface SATA 6 Gb/s. Il est conçu pour les charges de travail de stockage d'entreprise exigeantes, notamment les serveurs, les systèmes RAID, le stockage cloud et les centres de données. Seagate Exos X18 12 To : Caractéristiques principalesAvant de décider si ce disque dur d'entreprise convient à votre système, vous devez d'abord vérifier le numéro de modèle exact.La page produit AILINK100 concerne le ST12000NM000J, la version SATA du disque dur Exos X18 de 12 To. La documentation de Seagate identifie également le ST12000NM000J comme un modèle standard SATA 6 Gb/s de 12 To. SpécificationSeagate Exos X18 12 To ST12000NM000JGamme de produitsSeagate Exos X18ModèleST12000NM000JCapacité12 ToFacteur de forme3,5 poucesInterfaceSATA 6 Gb/svitesse de broche7 200 tr/minCache256 MoTechnologie d'enregistrementCMRConception de la transmissionScellé à l'héliumTaux de transfert soutenuJusqu'à environ 270 Mo/sÉvaluation annuelle de la charge de travailJusqu'à 550 To/anMTBFJusqu'à 2,5 millions d'heures Les chiffres ci-dessus sont basés sur les informations produit actuelles d'AILINK100 et la documentation de Seagate pour l'Exos X18. Pour un déploiement réel, il est impératif de vérifier la référence exacte, le firmware, l'interface, le format de secteur et la compatibilité avec le serveur avant de passer une commande groupée. À quoi est conçu le Seagate Exos X18 12TB ?L'Exos X18 appartient à la gamme de disques durs professionnels de Seagate plutôt qu'à ses produits de stockage destinés aux consommateurs.Cette distinction est importante lorsqu'on construit des infrastructures.Un disque dur d'entreprise de 12 To est généralement choisi lorsque vous avez besoin d'une combinaison de :Haute densité de stockageFonctionnement continuPerformances prévisibles et soutenuesRAID ou baies de stockage de grande capacitéCompatibilité avec les serveurs d'entrepriseCapacité de charge de travail annuelle élevéeÉconomie du déploiement à grande échelle La documentation de Seagate identifie la famille Exos X18 comme des disques d'entreprise et énumère des caractéristiques telles que la construction scellée à l'hélium, l'enregistrement CMR, la technologie d'alimentation en veille PowerChoice, la technologie d'alimentation/performance PowerBalance et la prise en charge du branchement à chaud.Pour vous, l'essentiel est simple : l'Exos X18 12 To est conçu pour faire partie d'une infrastructure de stockage, et non pas simplement comme un disque dur de bureau de grande capacité. Test des performances du Seagate Exos X18 12 To7 200 tr/min pour des performances constantes des disques durs d'entrepriseLe disque dur Exos X18 12TB fonctionne à 7 200 tr/min.Cela ne le rend pas comparable à un SSD NVMe en termes de latence ou de performances d'E/S aléatoires. Il ne faut pas acheter un disque dur d'entreprise en espérant une réactivité similaire à celle d'un SSD. Son avantage réside plutôt dans l'équilibre entre :Grande capacitéDébit séquentielCapacité de charge de travail d'entrepriseCoût par téraoctetOpération de longue duréePour les charges de travail dominées par des lectures et des écritures séquentielles, le stockage en masse, la sauvegarde, les référentiels multimédias, les lacs de données et autres applications axées sur la capacité, cette conception est beaucoup plus judicieuse que l'utilisation d'une capacité SSD haut de gamme pour chaque téraoctet. Débit de transfert soutenu jusqu'à environ 270 Mo/sLa documentation SATA Exos X18 indique des performances de transfert soutenues allant jusqu'à environ 270 Mo/s, en fonction de la capacité spécifique et des conditions de fonctionnement.Lorsque vous évaluez ce chiffre, tenez compte de la charge de travail.Si votre application est dominée par :Transferts de fichiers séquentielsSauvegarde et restaurationgrands ensembles de donnéesCharges de travail d'archivagedépôts vidéostockage de données en masseUn disque dur d'entreprise haute capacité peut constituer une couche de stockage efficace.Si votre charge de travail exige une latence extrêmement faible ou un nombre très élevé d'IOPS aléatoires, vous devriez plutôt envisager des SSD d'entreprise ou un stockage NVMe. Pourquoi le CMR est important sur l'Exos X18 12 ToL'une des spécifications les plus importantes à vérifier lors de l'achat d'un disque dur pour un système de stockage d'entreprise est la technologie d'enregistrement.L'Exos X18 utilise l'enregistrement magnétique conventionnel (CMR). La documentation produit de Seagate mentionne explicitement le CMR pour la gamme X18.Pourquoi est-ce important ?Lors de la conception de systèmes RAID ou d'autres systèmes de stockage à forte intensité d'écriture, un comportement d'écriture prévisible est essentiel. Les disques CMR sont généralement privilégiés pour les charges de travail où un comportement d'écriture soutenu et constant prime sur l'optimisation de la densité surfacique par des techniques d'enregistrement alternatives. Pour cette raison, le disque dur Exos X18 12 To peut constituer une option judicieuse lors de l'évaluation des disques durs pour :stockage RAIDserveurs de fichiers d'entrepriseSystèmes de sauvegardeGrandes baies de stockageNiveaux de capacité des centres de données Le Seagate Exos X18 12TB est-il CMR ou SMR ?Le Seagate Exos X18 12 To ST12000NM000J est un disque dur CMR, et non SMR. La documentation officielle de Seagate concernant l'Exos X18 mentionne l'enregistrement magnétique conventionnel comme une caractéristique de cette gamme.Il est important de vérifier ce point avant de déployer plusieurs disques durs dans un environnement RAID ou de stockage d'entreprise. Conception étanche à l'hélium : pourquoi c'est importantL'Exos X18 utilise une conception de disque dur scellée à l'hélium.Seagate cite l'architecture étanche à l'hélium comme l'une des caractéristiques essentielles de la gamme Exos X18.L'objectif pratique est de réduire la résistance subie par les plateaux et les têtes internes par rapport à une conception remplie d'air, contribuant ainsi à une densité de stockage et une efficacité énergétique plus élevées.Pour un trajet unique, cette différence n'est peut-être pas le principal facteur d'achat.Pour un système de stockage contenant des dizaines ou des centaines de disques, de petites différences de puissance et de densité peuvent toutefois devenir beaucoup plus significatives.C’est l’une des raisons pour lesquelles la conception des disques durs d’entreprise doit être évaluée au niveau du système, et non pas uniquement en fonction de la capacité et de la vitesse de rotation. Charge de travail et fiabilité du Seagate Exos X18 12 ToLa fiche technique AILINK100 spécifie une capacité de charge de travail annuelle allant jusqu'à 550 To/an et un MTBF de 2,5 millions d'heures pour la configuration ST12000NM000J répertoriée.Ces chiffres sont utiles pour comparer les disques durs d'entreprise, mais il faut les interpréter correctement.Le MTBF (temps moyen entre les pannes) n'est pas une prédiction quant à la durée de fonctionnement d'un disque dur individuel (2,5 millions d'heures). Il s'agit d'une mesure statistique de fiabilité utilisée pour l'évaluation des produits et des flottes.De même, la charge de travail annuelle doit être comparée à votre trafic de stockage prévu.Par exemple, si votre serveur effectue des sauvegardes fréquentes, des transferts de données importants, des charges de travail analytiques ou d'autres opérations à volume élevé, l'estimation du volume annuel de données écrites et lues peut vous aider à déterminer si un disque dur d'entreprise est correctement spécifié. Le disque dur Seagate Exos X18 de 12 To est-il adapté aux serveurs ?Oui, à condition que l'interface, le format de secteur, le firmware et la compatibilité physique correspondent à votre serveur ou contrôleur de stockage.L'Exos X18 est conçu pour les environnements d'entreprise, et Seagate propose des variantes SATA et SAS au sein de la famille X18.Pour le modèle ST12000NM000J en particulier, vous regardez la version SATA 6 Gb/s.Avant d'acheter, vérifiez :Votre fond de panier serveur prend-il en charge le SATA 6 Gb/s ?Le contrôleur RAID est-il compatible avec le disque ?Le format 3,5 pouces est-il pris en charge ?Votre serveur accepte-t-il la capacité du disque ?Le format des secteurs est-il compatible avec votre logiciel de stockage ?Le fournisseur du serveur indique-t-il que ce disque dur ou un modèle équivalent est compatible ?Ceci est particulièrement important pour les achats en entreprise, car un disque dur physiquement compatible n'est pas nécessairement un disque dur entièrement validé pour chaque plateforme serveur. Le disque dur Seagate Exos X18 de 12 To est-il adapté au RAID ?Le SSD Exos X18 est conçu pour les environnements de stockage d'entreprise et peut être utilisé dans des architectures RAID lorsque le contrôleur RAID, le serveur, le fond de panier et la configuration du firmware sont compatibles. AILINK100 positionne spécifiquement le ST12000NM000J pour les systèmes RAID et les charges de travail de stockage d'entreprise.Pour un déploiement RAID, il convient toutefois d'évaluer plus que le disque dur lui-même.Considérer:Niveau RAIDNombre de lecteursCompatibilité avec les manettesStratégie de rechange à chaudTemps de reconstructionPolitique de sauvegardeConception du domaine de défaillanceCharge de travail prévueCapacité utile requisePar exemple, augmenter le nombre de disques durs de 12 To peut fournir une capacité brute substantielle, mais la configuration RAID détermine la part de cette capacité réellement disponible pour vos applications.Autrement dit, 12 To par disque ne signifie pas 12 To de stockage utilisable par disque après configuration RAID. SATA ou SAS : assurez-vous de choisir le bon modèle d’Exos X18C'est l'un des critères d'achat les plus importants.La gamme Exos X18 comprend différentes interfaces et références.Pour 12 To, la documentation de Seagate indique :ST12000NM000J — SATA 6 Gb/sST12000NM004J — SAS 12 Gb/sIl existe également des variantes SED et SED-FIPS avec des numéros de modèle différents.Par conséquent, si votre système de stockage nécessite du SAS, vous ne devez pas commander automatiquement le SATA ST12000NM000J simplement parce que sa capacité est correcte.De même, si votre serveur est conçu autour de SATA, vous devez vérifier qu'un modèle SAS est effectivement pris en charge avant de changer d'interface. Comparaison rapideExigenceST12000NM000JST12000NM004JCapacité12 To12 ToInterfaceSATA 6 Gb/sSAS 12 Gb/sDéploiement typiqueServeurs/systèmes de stockage SATASystèmes de stockage d'entreprise SASMême modèle ?NoNoremplacement directUniquement lorsque le système le prend en chargeUniquement lorsque le système le prend en chargeLa documentation officielle de Seagate doit être votre référence finale pour les spécifications au niveau du modèle. À qui s'adresse le Seagate Exos X18 12 To ?Ce disque est particulièrement pertinent lorsque vous avez besoin d'un stockage HDD de grande capacité et que votre infrastructure prend en charge les disques SATA d'entreprise.1. Serveurs de fichiers d'entrepriseSi vous avez besoin de volumes importants de données d'entreprise partagées, la capacité de 12 To peut vous aider à augmenter la densité de stockage sans avoir à déplacer toutes les charges de travail vers un SSD. 2. Stockage de sauvegarde et de reprise après sinistrePour les référentiels de sauvegarde, la capacité et le coût par téraoctet sont souvent plus importants que la latence ultra-faible.L'Exos X18 peut donc constituer une solution pertinente en tant que couche de stockage haute capacité, à condition que l'architecture de sauvegarde globale soit correctement conçue. 3. Baies de stockage RAIDL'enregistrement CMR et les spécifications orientées entreprise rendent ce disque pertinent pour les grandes baies de disques durs, sous réserve de compatibilité avec le contrôleur et la plateforme. 4. Stockage du centre de donnéesSi vous gérez un grand nombre de disques durs, la densité de capacité, la capacité de charge, l'efficacité énergétique et le fonctionnement prévisible deviennent des critères d'achat importants.Le positionnement de l'Exos X18 sur le marché des entreprises et son architecture étanche à l'hélium sont conçus pour ce type d'environnement. 5. Stockage dans le cloud et à très grande échelleLa gamme Exos X18 est conçue pour les applications de stockage d'entreprise et hyperscale.Pour les déploiements de grande envergure, il convient toutefois d'évaluer la plateforme de stockage complète plutôt que de sélectionner les disques individuellement. Qui ne devrait pas acheter un Exos X18 12 To ?Réfléchissez-y à deux fois si votre principale exigence est une latence extrêmement faible ou des performances d'E/S aléatoires très élevées.Pour des charges de travail telles que :Bases de données à haut volume de transactionsEntraînement de l'IA, stockage temporaireNiveaux de virtualisation à haut débit d'IOPSStockage d'applications à faible latenceCharges de travail de métadonnées critiques en termes de performancesUn SSD NVMe d'entreprise ou un autre SSD d'entreprise pourrait être plus approprié.Le point fort de l'Exos X18 réside dans son stockage HDD haute capacité pour entreprises, et non dans le remplacement des SSD NVMe pour les charges de travail sensibles à la latence. Disques durs Seagate Exos X18 12 To vs Disques durs grand publicPourquoi choisir un disque dur d'entreprise plutôt qu'un disque dur de bureau classique ?La réponse est la charge de travail cible.Les disques durs grand public sont généralement optimisés pour une utilisation informatique personnelle économique et le stockage général.L'Exos X18 est conçu pour répondre aux exigences des entreprises, telles que :Fonctionnement 24h/24 et 7j/7Charges de travail annuelles élevéesStockage à grande échelleEnvironnements RAIDDéploiements de centres de donnéesexigences de fiabilité de l'entrepriseLa documentation officielle de Seagate répertorie les technologies et fonctionnalités destinées aux entreprises dans toute la famille Exos X18, notamment CMR, la construction scellée à l'hélium, PowerChoice, PowerBalance et la prise en charge du branchement à chaud. Si vous construisez une baie de stockage critique pour votre activité, la comparaison correcte n'est donc pas simplement :« Quel disque dur de 12 To est le moins cher ? » Une meilleure question serait :« Quel disque dur de 12 To convient à ma charge de travail, à mon architecture de stockage et à mon environnement d'exploitation prévu ? » Seagate Exos X18 12 To : Principaux avantages et limitationsAvantagesCapacité élevée de 12 To : Vous pouvez ajouter une capacité de stockage importante tout en conservant un nombre de disques gérable.Conception orientée entreprise : L'Exos X18 est conçu pour les applications de stockage d'entreprise plutôt que pour les charges de travail de bureau ordinaires.Enregistrement CMR : Utile pour les applications où un comportement d'écriture cohérent est important.7 200 tr/min : Offre un équilibre raisonnable entre les performances, la capacité et l'efficacité opérationnelle du disque dur.Cache de 256 Mo : Fournit une mémoire tampon supplémentaire pour les charges de travail de stockage.Architecture scellée à l'hélium : Compatible avec la conception haute densité de la gamme Exos X18.Interface SATA 6 Gb/s : Rend le ST12000NM000J compatible avec les serveurs et systèmes de stockage SATA. LimitesLatence du disque dur :Il ne peut rivaliser avec les SSD NVMe d'entreprise en termes de latence et d'E/S aléatoires.Compatibilité spécifique à l'interface :Vous devez vérifier que votre serveur ou contrôleur prend en charge SATA.Une capacité brute de 12 To ne correspond pas toujours à une capacité utilisable de 12 To :Le RAID, le formatage du système de fichiers et la surcharge système réduisent la capacité disponible.Acoustique et vibrations des disques durs d'entreprise :Un disque dur de classe centre de données n'est peut-être pas le choix idéal pour un environnement domestique ou de bureau calme. Comment choisir le Seagate Exos X18 12 To pour un projet de serveur ?Si vous achetez un seul disque dur pour évaluation, la procédure est relativement simple.Pour un déploiement en entreprise ou dans un centre de données, l'approche à adopter pour l'achat est différente.Étape 1 : Confirmer la référence exacteNe commandez pas simplement en recherchant « Exos X18 12TB ».Confirmez si vous avez besoin de :ST12000NM000J SATAou un autre modèle tel que :ST12000NM004J SASLa documentation de Seagate confirme qu'il s'agit de différentes variantes d'interface. Étape 2 : Vérifier la compatibilité du serveurVeuillez fournir vos informations :Marque du serveurModèle de serveurcontrôleur RAIDFond de panierModèle de disque dur existantCapacité requiseInterfaceCela permet à votre fournisseur de vérifier la compatibilité avant que vous n'achetiez en grande quantité. Étape 3 : Calcul de la capacité RAID utilisableSi vous achetez plusieurs disques de 12 To, calculez la capacité utilisable en fonction de votre niveau RAID plutôt que de simplement multiplier 12 To par le nombre de disques. Étape 4 : Tenez compte de votre charge de travail annuelleComparez votre charge de travail prévue à la charge de travail nominale du disque.AILINK100 indique que le ST12000NM000J a une capacité de charge de travail annuelle allant jusqu'à 550 To/an. Étape 5 : Demander un échantillon avant un déploiement à grande échellePour les projets d'entreprise de grande envergure, tester un disque d'essai dans votre serveur et environnement RAID réels est une pratique d'approvisionnement judicieuse.Vous pouvez valider :Détection de conduiteCompatibilité avec les contrôleurs RAIDComportement du firmwareInformations SMARTPerformance soutenueTempératureReconstruire le comportementC'est beaucoup plus sûr que de découvrir un problème de compatibilité après avoir acheté un lot entier. Verdict final : Le Seagate Exos X18 12 To vaut-il la peine d’être pris en considération ?Le Seagate Exos X18 12TB ST12000NM000J est une option intéressante si votre priorité est le stockage SATA d'entreprise haute capacité plutôt que la latence d'un SSD.Vous devriez y réfléchir si vous en avez besoin :Capacité de disque dur d'entreprise de 12 Toperformances à 7 200 tr/minEnregistrement CMRconnectivité SATA 6 Gb/sstockage compatible RAIDDéploiement de serveur ou de centre de donnéesCapacité de charge de travail annuelle élevéeDensité de stockage à grande échelle Vous devriez envisager des alternatives SSD d'entreprise ou NVMe si votre charge de travail est dominée par des E/S aléatoires, des applications sensibles à la latence ou des exigences IOPS très élevées. Surtout, ne choisissez pas votre disque uniquement en fonction de sa capacité. Avant de passer commande, vérifiez scrupuleusement le modèle, l'interface, la compatibilité avec le contrôleur, la charge de travail, la configuration RAID et l'environnement de déploiement. Concernant le modèle ST12000NM000J, AILINK100 le présente comme un disque dur Seagate Exos X18 SATA de 12 To pour entreprises, avec une vitesse de 7 200 tr/min, 256 Mo de cache, l'enregistrement CMR et une interface SATA 6 Gb/s. Vous pouvez consulter la page produit pour vous renseigner sur la disponibilité, le prix et la compatibilité avec votre serveur ou projet de stockage. Questions fréquentes concernant le disque dur Seagate Exos X18 12 ToLe disque dur Seagate Exos X18 12 To est-il un bon disque dur pour entreprises ?Oui. La gamme Exos X18 est une famille de disques durs d'entreprise conçue pour les environnements de stockage à grande échelle. Le modèle ST12000NM000J offre une capacité de 12 To, une vitesse de 7 200 tr/min, une connectivité SATA 6 Gb/s, l'enregistrement CMR et des spécifications adaptées aux charges de travail d'entreprise. Le Seagate Exos X18 12TB est-il certifié CMR ?Oui. La gamme Exos X18 utilise l'enregistrement magnétique conventionnel (CMR), y compris le modèle ST12000NM000J de 12 To. Le disque dur Seagate Exos X18 de 12 To est-il adapté au RAID ?Oui, à condition que le serveur, le contrôleur RAID, le fond de panier, le firmware et l'interface du disque soient compatibles. Il est conçu pour le stockage d'entreprise et les applications RAID. Le ST12000NM000J est-il SATA ou SAS ?Le modèle ST12000NM000J est un disque dur SATA 6 Gb/s de 12 To. La variante SAS de 12 To est le ST12000NM004J. Quelle est la vitesse du disque dur Seagate Exos X18 12 To ?La documentation SATA Exos X18 spécifie des performances de transfert soutenues allant jusqu'à environ 270 Mo/s, en fonction du modèle exact et des conditions de fonctionnement. L'Exos X18 est-il meilleur qu'un SSD ?Pas systématiquement. L'Exos X18 est mieux adapté au stockage HDD d'entreprise à haute capacité et économique, tandis que les SSD d'entreprise sont généralement préférables pour les charges de travail exigeant une latence très faible et un nombre élevé d'IOPS aléatoires. Peut-on utiliser un disque dur Exos X18 de 12 To dans un serveur ?Oui, à condition que le serveur, le fond de panier, le contrôleur de stockage, le firmware, le format, l'interface et le format de secteur soient compatibles avec le disque. Pour le ST12000NM000J, une architecture de stockage SATA compatible est requise. Où peut-on acheter le Seagate Exos X18 12TB ST12000NM000J ?AILINK100 propose actuellement le disque dur Seagate Exos X18 12 To ST12000NM000J et assure un service de renseignements produits ainsi qu'un accompagnement dans l'acquisition de solutions de stockage pour entreprises. Pour les déploiements de grande envergure, il est conseillé de fournir la configuration de votre serveur ou de votre système de stockage afin de vérifier la compatibilité avant tout achat.
  • Meilleurs disques durs d'entreprise en 2026 pour un stockage évolutif
    Meilleurs disques durs d'entreprise en 2026 pour un stockage évolutif
    August 13, 2026
    Vous avez besoin des meilleurs disques durs d'entreprise en 2026 pour faire évoluer efficacement une infrastructure serveur massive. Les environnements de stockage cloud haute densité nécessitent des disques éprouvés comme le Seagate Exos Série X, Western Digital Gold et série Toshiba MG. Ces disques durs professionnels supportent les charges de travail continues et intensives de votre centre de données.Votre stratégie d'approvisionnement doit prendre en compte des indicateurs clés autres que le simple coût initial par téraoctet. Il est essentiel d'adapter la capacité de charge des disques aux exigences de votre système lors du choix de l'interface SAS ou SATA pour chaque châssis de serveur. Les disques durs mécaniques modernes haute capacité garantissent une fiabilité opérationnelle optimale tout au long de l'année. Choisir le matériel adéquat protège votre investissement dans un stockage évolutif. Points clés à retenirChoisissez des disques haute capacité comme les Seagate Exos ou les WD Gold pour faire évoluer efficacement votre centre de données.Adaptez les interfaces de disque SAS ou SATA à votre châssis de serveur et à vos exigences de charge de travail.Associez des disques SSD haute vitesse à des disques durs mécaniques pour créer un système de stockage hiérarchisé et équilibré.Les systèmes d'entraînement à hélium étanches réduisent les frottements internes des gaz et diminuent la consommation d'énergie globale de cinquante pour cent. Meilleurs disques durs d'entreprise pour 2026Vous avez besoin des meilleurs disques durs d'entreprise pour gérer les volumes opérationnels croissants de votre infrastructure. Choisir des disques haute capacité disque dur de stockage d'entreprise Les disques permettent à votre centre de données d'atteindre une efficacité optimale. Les châssis de serveurs modernes utilisent des disques spécialisés conçus pour supporter des charges de travail continues et importantes. Disques de pointe pour une densité de données massiveLes principaux fabricants proposent des disques durs pour serveurs aux performances exceptionnelles, conçus pour les environnements rack exigeants. Seagate offre des capacités maximales grâce à sa plateforme Mozaic 3+ HAMR, atteignant 32 To avec le disque Exos M ST32000NM000K. Vous pouvez également opter pour le Seagate Exos M ST30000NM004K (30 To SATA) ou l'Exos X24 ST24000NM007H (24 To SAS).Western Digital élargit sa gamme de disques durs pour entreprises avec le WD Gold de 26 To, qui exploite les technologies ePMR et OptiNAND. De son côté, Toshiba propose la série MG11 de 24 To, utilisant la technologie FC-MAMR et un cache de 1 Go. Le tableau ci-dessous compare ces deux modèles phares selon leurs principales caractéristiques techniques :ModèleCapacitéInterfaceÉvaluation de la charge de travailVitesse de rotationSeagate Exos M ST32000NM000K32 ToSATA 6 Gb/s550 To/an7200 tr/minSeagate Exos M ST30000NM004K30 ToSATA 6 Gb/s550 To/an7200 tr/minDisque dur WD Gold 26 To26 ToSATA 6 Gb/s550 To/an7200 tr/minToshiba MG1124 ToSATA 6 Gb/s550 To/an7200 tr/minChaque option de disque dur pour entreprises inclut des fonctionnalités essentielles telles que la protection contre les vibrations rotationnelles et une garantie de 5 ans. Ces fonctionnalités garantissent la stabilité du système même avec des dizaines de disques installés dans un seul châssis serveur. Comparaison des performances des principaux modèlesL'évaluation de la vitesse des disques durs mécaniques vous permet d'adapter chaque disque dur de serveur à votre charge de travail opérationnelle. Les vitesses de lecture et d'écriture varient selon les technologies, comme le montrent les tests des fabricants et les évaluations indépendantes.Modèle de conduiteVitesse nominaleLecture séquentielle indépendanteÉcriture séquentielle indépendanteSeagate Exos M 30 To275 Mo/s292 Mo/s289 Mo/sWestern Digital Gold 26 To288 Mio/s (~302 Mo/s)283–285 Mo/sNon signaléToshiba MG11 24 To295 Mio/s (~309 Mo/s)Données limitéesNon signaléLe débit séquentiel ne représente qu'un aspect des performances globales d'un disque. Il est également essentiel d'évaluer les IOPS en accès aléatoire lors de la configuration d'un serveur pour des applications de stockage cloud mixtes. Les disques mécaniques standard offrent des performances en accès aléatoire modérées par rapport aux disques durs mécaniques classiques. SSD de qualité professionnelle pour centres de donnéesCependant, les disques durs de serveur haute densité restent essentiels pour une conservation de données en masse rentable.Comme le montre le graphique, le disque dur Seagate IronWolf Pro 22 To (7 200 tr/min) atteint environ 210 IOPS en lecture aléatoire 4K et environ 230 IOPS en écriture aléatoire 4K. Le Seagate Exos X20 18 To atteint environ 190 IOPS en lecture aléatoire 4K et environ 210 IOPS en écriture aléatoire 4K. Le WD Red Plus 14 To (5 400 tr/min) est en retrait avec environ 150 IOPS en lecture aléatoire 4K et environ 170 IOPS en écriture aléatoire 4K.L'intégration de disques durs serveur hautes performances et de couches de cache SSD permet de créer des architectures de stockage équilibrées. Des fonctionnalités d'entreprise avancées, telles que la limitation thermique, assurent la santé des disques dans les baies à haute densité. De plus, le chiffrement matériel protège les données sensibles sur les serveurs actifs. Choisir les meilleurs disques durs d'entreprise garantit une capacité évolutive, une longue durée de vie et un débit constant pour votre parc de disques durs. Critères de sélection clés pour les disques durs d'entrepriseIl est essentiel d'évaluer les facteurs techniques critiques avant d'acheter des disques durs de stockage d'entreprise haute capacité pour votre baie de stockage. Choisir l'architecture de disque appropriée permet d'éviter les goulots d'étranglement du système et d'optimiser la densité physique. Capacité, interface et vitesse de rotationLe choix de l'interface détermine la topologie globale du système et influence la vitesse de communication. L'infrastructure d'entreprise repose principalement sur les protocoles SAS (Serial Attached SCSI) et SATA (Serial ATA).Un contrôleur SAS ou un fond de panier accepte les disques SATA, mais un contrôleur SATA n'acceptera jamais un disque SAS.Cette règle de conception matérielle régit la correspondance des connexions dans chaque baie. Un disque dur SAS double port pour entreprises offre une redondance multi-chemins pour les opérations critiques, tandis que le SATA propose des connexions économiques pour les volumes importants de données. Il est recommandé d'opter pour des SSD de qualité professionnelle pour les centres de données lorsque vos charges de travail exigent des temps d'accès inférieurs à la milliseconde. Cependant, les disques durs mécaniques offrent un meilleur rapport coût/efficacité de stockage par téraoctet. La vitesse de rotation de la broche influe directement sur la latence d'accès et le débit séquentiel, comme indiqué dans le tableau suivant :vitesse de brocheClassePoints fortsIdéal pour7 200 tr/minLigne médiane / ligne proche (3,5")Capacité maximale, coût par téraoctet le plus bas, faible consommation d'énergieSauvegardes, archives, stockage à froid de masse10 000 tr/minEntreprise (2,5")Équilibre entre vitesse, capacité et densitéCharges de travail à usage général et à performances modérées15 000 tr/minEntreprise de performance (2,5")Latence disque dur minimale, IOPS disque dur maximalesbesoins de performance héritésL'augmentation de la vitesse de rotation de 7 200 à 10 000 tr/min réduit la latence de rotation moyenne de 4,17 ms à 3,00 ms. Cependant, des vitesses de rotation plus élevées augmentent la consommation électrique et la dissipation thermique des disques dans les configurations à forte densité de stockage. Par conséquent, les disques nearline à 7 200 tr/min constituent la principale solution de stockage haute densité pour les serveurs disposant d'un parc de disques important. L'évaluation des spécifications d'endurance garantit que votre configuration de disques durs supporte le trafic d'écriture prévu sans défaillance inattendue. L'endurance est mesurée en octets écrits (TBW) ou en écritures par jour (DWPD). Adapter l'endurance des disques au volume d'écriture quotidien assure la stabilité globale du serveur. Heures de fonctionnement, MTBF et caractéristiques de fiabilitéLes systèmes de centres de données nécessitent un fonctionnement continu, ce qui rend la durabilité du matériel de stockage essentielle. Les disques durs d'entreprise modernes répondent aux exigences opérationnelles continues grâce à des normes de fabrication rigoureuses. Les administrateurs système commencent à planifier le remplacement des disques durs autour de 25 000 à 30 000 heures de fonctionnement afin d'éviter les interruptions matérielles imprévues. Vous pouvez évaluer les probabilités de défaillance statistique à l'aide de formules de fiabilité établies.Métrique de fiabilitéFormuleImpact sur la sélectionMTBF (Temps moyen entre les pannes)Durée totale de fonctionnement entre les pannes / nombre de pannesDes valeurs plus élevées indiquent une durée de vie prévue plus longue et un risque d'indisponibilité plus faible.Taux de charge de travail annuel(Nombre total d'écritures + Nombre total de lectures) * (8760 / Durée totale d'utilisation)Le dépassement des limites de transfert nominales accélère l'usure et annule les garanties.La conception matérielle intègre des fonctionnalités spécifiques aux entreprises afin de protéger les baies multi-disques haute densité. Des capteurs de vibrations rotationnelles intégrés détectent les mouvements externes du châssis. Le contrôleur interne ajuste la position des actionneurs pour compenser les perturbations dynamiques provenant des disques adjacents.La récupération d'erreurs limitée dans le temps (TLER) limite les tentatives de récupération des secteurs défectueux à environ 7 secondes, en notifiant immédiatement le contrôleur RAID matériel afin de préserver la stabilité de la matrice.Ces fonctionnalités d'entreprise optimisent la gestion des erreurs de disque tout en maintenant la réactivité du serveur sous forte charge. Des protocoles de mise en file d'attente de firmware spécialisés améliorent les performances multi-clients lors de l'exécution de commandes en parallèle. Des fonctionnalités d'entreprise telles que le stationnement actif des têtes de lecture/écriture, des algorithmes avancés de protection des données et une gestion automatisée de l'alimentation réduisent les risques opérationnels. Le choix d'un matériel doté de fonctionnalités d'entreprise robustes garantit la fiabilité opérationnelle de l'ensemble de votre infrastructure de disques durs serveur. Adaptation de la charge de travail et architecture de disqueExigences d'interface SAS vs SATALe choix des disques durs serveur doit être adapté aux exigences opérationnelles spécifiques. Les disques durs d'entreprise avec interface SAS prennent en charge un débit de 12 à 24 Gbit/s et offrent des fonctionnalités avancées de détection et de correction d'erreurs. En revanche, les disques durs serveur SATA offrent des vitesses de transfert jusqu'à 6 Gbit/s, ainsi que des fonctions de correction d'erreurs de base. Un disque dur serveur SAS est idéal pour les bases de données critiques, les plateformes de commerce électronique et les clusters de machines virtuelles nécessitant des transactions multithread sans latence.Les administrateurs de stockage déploient des disques SSD lorsque les opérations de charge de travail exigent un accès instantané aux données. Le déploiement de baies SSD rapides aux côtés d'un stockage nearline permet de créer une topologie équilibrée. L'évaluation de l'endurance des disques prévient les défaillances matérielles prématurées dans les environnements d'écriture continue. Les applications à forte intensité de lecture nécessitent une endurance plus faible, de l'ordre de 1 DWPD ou moins. Les charges de travail à usage mixte requièrent une endurance de 3 DWPD pour le traitement transactionnel. Les pipelines d'ingestion de données à forte intensité d'écriture exigent une endurance de 10 DWPD pour supporter un volume important d'écritures quotidiennes. Cette hiérarchisation stratégique optimise les performances globales du système sur l'ensemble des nœuds de stockage. Technologies de l'hélium et innovations en matière d'actionneursLe scellage à l'hélium augmente la capacité des disques en éliminant les turbulences d'air internes. L'utilisation d'un gaz inerte à l'intérieur du châssis permet d'intégrer neuf plateaux fins dans un format standard de disque dur serveur 3,5 pouces. Les disques durs Toshiba série MG08, scellés à l'hélium, réduisent la consommation d'énergie par gigaoctet d'environ 50 % par rapport aux disques durs à air. Cette réduction de la consommation d'énergie accroît la capacité des racks tout en maintenant des températures de fonctionnement optimales dans chaque châssis serveur. Des fonctionnalités avancées pour entreprises protègent le positionnement des têtes de lecture/écriture contre les vibrations continues.Les innovations en matière d'actionneurs garantissent un positionnement précis des têtes de lecture/écriture sur des plateaux magnétiques à haute densité. Les actionneurs à double étage combinent un milli-actionneur de 200 nm et un micro-actionneur de 100 nm pour un alignement optimal des pistes. Les ensembles multi-actionneurs, tels que le Seagate MACH.2, doublent les performances d'IOPS et améliorent les performances séquentielles tout en offrant des vitesses de lecture soutenues jusqu'à 480 Mo/s. Ces fonctionnalités dédiées aux entreprises optimisent l'exécution mécanique des disques durs de serveur grâce à la mise en cache secondaire sur SSD. Le déploiement de chaque disque dur de serveur haute densité doté de ces fonctionnalités modernes garantit une fiabilité élevée du serveur. Déploiement de disques dans une infrastructure évolutiveIntégration au sein des systèmes de stockage hiérarchisésVous pouvez construire une infrastructure de stockage de données évolutive en associant des SSD de qualité professionnelle pour centres de données à des disques durs de stockage d'entreprise haute capacité. Les architectures hybrides modernes déploient des disques SSD rapides ou un SSD d'entreprise dédié en périphérie du réseau. Les fonctionnalités d'entreprise intégrées permettent à cette couche d'acheminer les rafales d'écriture vers une couche cache SSD haute vitesse. Ainsi, votre infrastructure de stockage traite les requêtes de lecture et d'écriture entrantes avec une latence minimale tout en protégeant les baies de disques principales.Votre contrôleur de stockage déplace les fichiers de données les plus anciens vers un pool de disques durs serveur dédié à leur conservation à long terme. Par exemple, les grands clusters d'entraînement d'IA déploient 46 Po de cache NVMe répartis sur 6 080 GPU afin d'optimiser les performances des charges de travail pendant les opérations actives. Les tâches de point de contrôle écrivent les données temporaires sur une mémoire flash haute vitesse avant de les migrer vers des baies de disques durs serveur de grande capacité. Ce déploiement hiérarchisé préserve l'endurance en écriture tout en optimisant la capacité totale de stockage sur votre réseau de stockage cloud. Densité du châssis, gestion thermique et expansionLes châssis haute densité nécessitent une protection environnementale adéquate afin de préserver le matériel serveur des dommages physiques. L'installation d'un disque dur serveur dans un châssis rack dense engendre des charges thermiques et des vibrations acoustiques importantes. Ces fortes vibrations mécaniques dégradent la précision de lecture du disque et contraignent l'actionneur interne à se réaligner constamment. Il est donc impératif de surveiller les indicateurs d'endurance en écriture du disque dur serveur et d'activer les fonctionnalités dédiées aux entreprises afin de maintenir les performances du système sous charge opérationnelle continue.Vous pouvez atténuer les contraintes physiques grâce à des méthodes de gestion ciblées de l'enceinte :Configurez les profils de ventilation pour maintenir les disques durs inactifs en dessous de 45 °C.Utilisez des plateaux de montage anti-vibrations pour obtenir une réduction des vibrations de 12 à 18 dB.Activez les temporisateurs de démarrage séquentiels pour éliminer les pics d'impulsion transitoires à la mise sous tension.Mettre en œuvre un système de refroidissement liquide par immersion de précision pour égaliser les températures des disques et maintenir des performances optimales.L'ajout d'un système de stockage en réseau (NAS) augmente la capacité globale sans réduire la durée de vie des disques. Les protocoles de firmware intégrés gèrent la mise en veille des têtes de lecture et les lectures de surveillance en arrière-plan afin de préserver l'intégrité du système. Les serveurs modernes utilisent des fonctionnalités professionnelles avancées pour isoler les vibrations des châssis multi-disques. Le déploiement de disques durs de serveur à vitesse de rotation identique garantit un fonctionnement prévisible sur l'ensemble de votre infrastructure en expansion. Sélectionner le meilleur disques durs d'entreprise Il est nécessaire de trouver un équilibre entre une capacité élevée et la fiabilité du matériel à long terme. Il faut évaluer les coûts d'acquisition initiaux ainsi que la consommation électrique et les exigences de charge de travail. Une infrastructure de données moderne repose sur l'adéquation de chaque disque serveur aux besoins de charge de travail. Il est conseillé d'associer des disques durs d'entreprise haute densité à du stockage flash pour optimiser le débit du système.Avant de passer votre commande, vous devez vérifier la compatibilité matérielle complète. Assurez-vous que votre adaptateur de bus hôte prend en charge le protocole de disque sélectionné. De plus, vérifiez que le fond de panier et le châssis de votre serveur respectent les exigences thermiques et vibratoires. La vérification de ces exigences serveur avant le déploiement protège votre investissement infrastructurel et garantit un fonctionnement sans interruption. FAQFaut-il choisir des disques durs de stockage d'entreprise haute capacité SAS ou SATA ?Pour les charges de travail critiques exigeant une redondance à deux ports et des vitesses de transfert allant jusqu'à 12-24 Gbit/s, privilégiez le SAS. Pour une conservation de données en masse économique avec des vitesses de transfert jusqu'à 6 Gbit/s, optez pour le SATA. Vérifiez que votre adaptateur de bus hôte prend en charge l'interface sélectionnée.Comment les SSD de qualité professionnelle pour centres de données fonctionnent-ils avec les disques durs mécaniques ?Vous pouvez associer des SSD hautes performances de qualité professionnelle pour centres de données à des disques durs mécaniques dans une architecture hiérarchisée. La couche SSD rapide gère les pics d'écriture et les requêtes de lecture fréquentes. Votre système transfère ensuite les données peu utilisées vers des disques durs mécaniques pour un stockage évolutif à long terme.Pourquoi les disques durs de serveurs haute densité utilisent-ils la technologie à l'hélium ?L'hélium scellé réduit les frottements internes et les turbulences de l'air à l'intérieur du châssis. Cette conception permet aux fabricants d'intégrer jusqu'à neuf plateaux fins dans un format standard de disque dur 3,5 pouces. Cette technologie diminue la consommation d'énergie par gigaoctet d'environ 50 % tout en maintenant des températures de fonctionnement optimales.Qu'est-ce que la récupération d'erreurs à durée limitée (TLER) dans les matrices RAID ?La récupération d'erreurs à durée limitée restreint les tentatives de récupération des secteurs défectueux du disque à environ 7 secondes. Le contrôleur du disque notifie rapidement le contrôleur RAID matériel des problèmes de secteurs. Ce processus empêche les déconnexions du disque de la grappe et maintient la stabilité globale du système de stockage sous de fortes charges opérationnelles.
  • Apprenez comment choisir le bon module de mémoire serveur DDR5 ECC
    Apprenez comment choisir le bon module de mémoire serveur DDR5 ECC
    August 05, 2026
    Choisir la meilleure mémoire vive DDR5 nécessite d'évaluer l'architecture des modules, la vitesse de transfert, la capacité par socket, l'efficacité énergétique et les exigences des charges de travail en entreprise. Les serveurs modernes hautes performances s'appuient sur des sous-systèmes de mémoire avancés pour prendre en charge des plateformes comme Intel Xeon Scalable et AMD EPYC. Déployer un module de mémoire serveur DDR5 offre une bande passante exceptionnelle et une latence ultra-faible pour les opérations critiques des centres de données. En effectuant une mise à niveau de la mémoire vive de votre serveur, vous améliorez immédiatement la fiabilité du système et l'intégrité du bus de données. La technologie DDR5 de nouvelle génération intègre une correction d'erreurs intégrée pour prévenir les interruptions matérielles imprévues. Vous protégez ainsi votre infrastructure d'entreprise grâce à des mises à niveau planifiées de vos serveurs. Une densité de mémoire adaptée garantit des performances optimales, même sous des charges de calcul importantes et continues. Points clés à retenirLa mise à niveau vers une mémoire serveur DDR5 augmente la bande passante du système et réduit la consommation d'énergie grâce à un fonctionnement efficace à 1,1 V.Choisir des architectures de modules modernes comme les RDIMM ou les MRDIMM optimise la vitesse de transfert des données pour les charges de travail importantes des entreprises.Des fonctionnalités avancées de correction d'erreurs protègent l'intégrité des données et évitent les interruptions de service coûteuses dans les centres de données.Le remplissage symétrique des canaux de mémoire garantit une vitesse de traitement optimale et maintient la stabilité globale du serveur.Comprendre les types et les architectures des modules DDR5Choisir l'architecture de module de mémoire serveur appropriée garantit la stabilité opérationnelle des serveurs d'entreprise. Il est essentiel de comprendre les différences de conception physique de la mémoire serveur pour optimiser les investissements matériels modernes. Les différentes charges de travail d'entreprise nécessitent des choix de mémoire adaptés à l'ensemble de l'infrastructure pour atteindre une efficacité maximale. Mécanismes de comparaison entre RDIMM, LRDIMM et MRDIMMType de mémoireÉléments structurels clésMécanismes et capacités opérationnelsApplications ciblesRDIMMTampon de registre intégréLes tampons mettent en mémoire tampon les signaux de commande, d'adresse et d'horloge afin de réduire la charge électrique sur le contrôleur de mémoire, ajoutant environ un cycle d'horloge de latence.Matériel serveur standard et systèmes à haute fiabilitéLRDIMMEnregistrement du pilote d'horloge et des tampons de donnéesLes tampons contrôlent les signaux et réorientent les lignes de données via des tampons de données, masquant les puces DRAM brutes du contrôleur afin de maximiser les limites de charge élevées.Matériel serveur standard et déploiements haute densitéMRDIMMMémoire tampon de multiplexage et logique de contrôle sur DIMMIl fait fonctionner simultanément deux rangs via un multiplexeur, doublant ainsi le débit du canal au-delà des débits natifs de la DDR5 (par exemple, ~70,4 Go/s à 8800 MT/s).IA, calcul haute performance (HPC) et plateformes de serveurs de nouvelle générationLes modules de mémoire multiplexés à double rangée (DIMM) utilisent un tampon de multiplexage intégré associé à une logique de contrôle dédiée pour combiner les opérations DDR5 double rangée. En gérant simultanément les flux de données sur plusieurs rangées de mémoire, ces modules avancés dépassent les limites de vitesse standard de la DDR5. Vous bénéficiez ainsi d'un débit de données plus élevé, d'une latence réduite, d'une capacité effective accrue et d'une efficacité énergétique optimisée. Ces modules transmettent une charge utile de 128 octets au processeur à chaque cycle, soit le double de la capacité de 64 octets des modules DDR5 standard lors d'opérations de calcul continues.Les MRDIMM intègrent une technologie de multiplexage à haute vitesse pour permettre un accès simultané aux rangs plutôt qu'un traitement séquentiel des opérations comme avec l'entrelacement de mémoire standard, doublant ainsi le débit de données effectif par broche et maximisant la bande passante.Accès simultané aux rangs : l'architecture MRDIMM permet l'activation et la récupération simultanées sur des paires de rangs DRAM, augmentant considérablement le débit par rapport aux opérations DDR5 standard à rang unique.Multiplexage des flux de données : intègre des composants spécialisés pour combiner les canaux de données, doublant ainsi la vitesse de transfert de données effective par broche (par exemple, en augmentant une fréquence DRAM native de 6 400 MT/s à une vitesse d’interface de 12 800 MT/s). Évaluation des topologies de canaux et des structures de classementLes architectures à double rang (2Rx4), comme celles des modules DDR5 64 Go pour entreprises, offrent un compromis optimal entre l'intégrité du signal et les limites d'extension. Ces structures permettent aux architectures système de maintenir une excellente qualité de signal tout en augmentant la densité de mémoire occupée. Lors de la conception des nœuds de serveur, les architectes système doivent également évaluer l'impact de la topologie des canaux sur les fréquences de fonctionnement. Le choix d'une architecture à rang équilibré prévient la dégradation du signal lors des calculs intensifs et simplifie la maintenance du serveur. Sur la plateforme Intel Eagle Stream, le passage d'une densité de canaux de 1DPC à 2DPC fixe les fréquences de fonctionnement maximales de la mémoire DDR5 à 4 400 MT/s pour les processeurs Xeon Scalable de 4e génération et à 4 800 MT/s pour ceux de 5e génération. Cependant, pour certains processeurs d'entrée et de milieu de gamme dont la fréquence est inférieure à 4 800 MT/s en 1DPC (par exemple, ceux fonctionnant à 4 000 MT/s ou 4 400 MT/s), le passage à une topologie 2DPC n'entraîne aucune perte de fréquence. Vous pouvez ainsi déployer des configurations 2DPC pour atteindre directement les vitesses de fonctionnement 1DPC, garantissant une fiabilité système à long terme et des performances stables dans tous les environnements cloud d'entreprise, sans compromettre la bande passante globale du bus.Adaptation des charges de travail d'entreprise aux modules de mémoire DDR5Les plateformes d'entreprise modernes nécessitent une bande passante évolutive pour gérer les opérations de calcul continues. La mise à niveau de vos nœuds de serveur avec de la mémoire vive DDR5 de haute qualité améliore considérablement le débit dans les environnements informatiques critiques. Le déploiement d'un module de mémoire serveur avancé offre des performances élevées et vous aide à optimiser la densité matérielle. Les modules de mémoire DDR5 haute densité éliminent les goulots d'étranglement des données dans les applications gourmandes en mémoire. Configurations de vitesse, de latence et de rang de la mémoire vive DDR5La fréquence de la mémoire influe directement sur la latence du système et le débit global de l'entreprise. Pour une vitesse maximale des canaux mémoire, privilégiez les modules à faible latence et à conception double rang optimisée. La mémoire DDR5 haute vitesse améliore l'efficacité des cœurs du processeur pour les charges de travail complexes.SpécificationDétailNormes et technologies de mémoireDDR5 PC5-44800Vitesse et bande passante5600 MT/s à 44800 MB/sFacteur de forme et brochesModule DIMM enregistré (RDIMM), 288 brochesCorrection d'erreurs et classementEnregistré ECC, 2Rx4Tension et synchronisation1,1 V, latence CAS 40 Pour établir une base de performance solide, considérez les Module RDIMM Samsung M321R8GA0PB0-CWMCJCe module fonctionne à une vitesse de 5 600 MT/s et présente une latence CAS de 40 cycles. Son architecture double rangée 2Rx4 répartit les charges électriques sur les pistes de la carte mère du serveur. Un fonctionnement à 1,1 V réduit la dissipation thermique à l'intérieur des châssis de serveurs compacts tout en maintenant une vitesse élevée sur les canaux mémoire.Débit de données élevé : Fonctionne à 5600 MT/s pour assurer un traitement rapide des charges de travail d'entreprise.Fiabilité accrue : La technologie ECC intégrée contribue à prévenir les pannes système en identifiant et en corrigeant les erreurs de mémoire.Capacité évolutive : Fournit 64 Go de mémoire par module pour gérer les applications serveur multitâches et gourmandes en ressources.Optimisation pour entreprises : Comprend une conception à 2 rangs x4 associée aux normes PC5-44800 pour la compatibilité avec les serveurs. Dimensionnement de la mémoire pour l'IA, les bases de données et la virtualisationLes applications d'entreprise exigent un débit de données massif et une latence mémoire stable. Le déploiement de mémoire vive DDR5 rapide accélère les pipelines d'analyse de données volumineuses et les temps de réponse aux requêtes de bases de données. Les frameworks d'apprentissage automatique traitent plus rapidement les grands nombres de paramètres grâce à la vitesse élevée de la mémoire DDR5. La bande passante élevée de la mémoire vive DDR5 assure une utilisation optimale des cœurs du processeur lors des tâches d'entraînement intensives.Le choix de modules DDR5 de 64 Go permet aux administrateurs système d'optimiser l'empreinte mémoire par socket tout en maintenant une faible latence lors de charges de travail parallèles importantes.Prise en charge de la virtualisation : Offre une capacité haute densité de 64 Go adaptée aux exigences de virtualisation des entreprises.Débit du serveur : Offre des vitesses DDR5-5600 conçues pour atténuer les goulots d’étranglement des performances dans les plateformes de serveurs modernes.Efficacité énergétique : Fonctionne avec une faible consommation de 1,1 V, réduisant considérablement la production de chaleur et la consommation d'énergie dans les baies de serveurs. Les moteurs de bases de données volumineuses nécessitent une latence stable pour traiter les requêtes simultanées des utilisateurs. Un dimensionnement adéquat de la capacité évite les cycles d'échange de disques qui dégradent la réactivité du système. Les plateformes cloud virtualisées tirent pleinement parti des mises à niveau de serveurs haute densité. Une planification précise de l'extension de la capacité mémoire garantit une densité stable de machines virtuelles sur l'ensemble des hyperviseurs. Vous optimisez les performances de votre infrastructure d'entreprise en adaptant les exigences des charges de travail aux architectures mémoire haute vitesse. Les modules DDR5 modernes constituent la base idéale pour des opérations de calcul évolutives dans les centres de données. Optimisation de l'architecture des canaux serveur pour un débit maximalPour atteindre un débit serveur optimal, il est nécessaire d'utiliser correctement les canaux de mémoire physique des processeurs modernes. Il faut équilibrer soigneusement ces canaux afin de maximiser la bande passante système des systèmes hautes performances. Serveur d'entreprises S'appuyer sur des configurations de canaux équilibrées pour traiter les tâches de calcul sans rencontrer de goulots d'étranglement du système. Calcul de la population et de la capacité du canalLe bon paramétrage des canaux mémoire détermine le débit système sur les plateformes d'entreprise. Vous optimisez les performances en paramétrant systématiquement les canaux mémoire du serveur selon des directives strictes du processeur.Remplissez les canaux de mémoire par socket en quantités précises de 1, 2, 4, 6, 8, 10 ou 12.Installez des modules de mémoire identiques sur chaque canal actif afin de préserver une configuration de canaux uniforme.Utilisez exactement la même configuration de barrettes DIMM pour chaque socket de processeur de votre serveur.Conserver des configurations de mémoire identiques sur tous les domaines NUMA sous les paramètres NPS2 ou NPS4.Une capacité maximale évite les ralentissements système importants lors d'opérations gourmandes en mémoire, comme la virtualisation ou le traitement de grands ensembles de données. L'ajout de RAM suffisante prévient les baisses de performances dues au recours à la pagination disque ou à l'échange de données du système d'exploitation. Vous garantissez une exécution fiable sur les serveurs d'entreprise en respectant les exigences de chaque canal de socket. Gestion des performances sur des configurations multi-DIMMLes configurations multi-DIMM impliquent des compromis physiques entre la vitesse de traitement, la latence et la consommation énergétique globale. Les modules DDR5 modernes intègrent des régulateurs de tension fonctionnant à une tension de base de 1,1 V. Cette conception permet une économie d'énergie théorique d'environ 15 à 20 % par rapport aux architectures DDR4 à 1,2 V. Des valeurs de latence CAS élevées, telles que CL40 à CL42, introduisent de légers délais de cycle d'horloge avant le début de l'accès aux données. Les accès séquentiels, comme l'encodage vidéo, tirent parti de la large bande passante de la DDR5 avec une pénalité de latence minimale. À l'inverse, les tâches non séquentielles, comme le traitement d'images en temps réel, subissent des retards dus à une latence accrue.Le fractionnement des modules DIMM DDR5 en plusieurs sous-canaux optimise le flux de données simultané. Ce parallélisme interne masque la latence brute de la DRAM lors des opérations parallèles. En choisissant un module de mémoire serveur DDR5 équilibré, vous préservez l'efficacité de l'architecture mémoire de votre serveur et la stabilité globale du système. Principales caractéristiques de fiabilité et de consommation d'énergie de la mémoire vive DDR5Le matériel des centres de données exige une fiabilité opérationnelle continue sous des charges de calcul intensives. Les applications d'entreprise modernes nécessitent des mécanismes de protection robustes pour prévenir les pannes système et les interruptions de service. Choisir du matériel de pointe garantit à votre infrastructure cloud une stabilité de niveau entreprise et une maîtrise thermique optimale. Correction d'erreurs ECC intégrée et correction d'erreurs à bande latéraleDimensions techniquesECC sur puceECC du bus DRAM à bande latéraleÉtendue de la couverturePuce DRAM interne uniquementChemin de données complet (puce, circuit imprimé, contrôleur de mémoire)Objectif principalAméliore la fiabilité des puces à mesure que la taille des cellules diminue.Garantit l'intégrité des données de bout en boutProtection en transitAucunProtection active du chemin de transmissionCapacité de correctionErreurs sur un seul bit (SEC)Correction d'erreur simple, détection d'erreur double (SEC-DED)La technologie DDR5 de nouvelle génération intègre une protection interne des cellules directement dans la puce DRAM. Celle-ci calcule et stocke 8 bits de correction d'erreurs internes pour chaque tranche de 128 bits de données. Ce mécanisme corrige localement les erreurs sur un seul bit lors des opérations de lecture. Cependant, les erreurs de transmission ne sont pas prises en compte. Les serveurs d'entreprise combinent une protection interne et un code de correction d'erreurs hors bande (SEC) pour sécuriser l'intégralité du flux de données. Cette protection complète du bus corrige les erreurs de transmission entre le contrôleur mémoire et le module. Ensemble, ces mécanismes améliorent la fiabilité matérielle et réduisent de 18 % les pannes liées à la mémoire dans les environnements critiques. L'intégrité des données est ainsi préservée sur tous les canaux de calcul actifs. Efficacité thermique et du circuit intégré de gestion de l'alimentation (PMIC) intégré au moduleLes modules classiques dépendaient des circuits de la carte mère pour la régulation de tension. La mémoire vive DDR5 moderne délègue la régulation de l'alimentation directement au module grâce à un circuit intégré de gestion de l'alimentation. Ce contrôleur intégré reçoit une tension d'entrée de 5 V et l'abaisse localement à 1,1 V.Trajets d'alimentation plus courts : le placement de la régulation sur le module raccourcit la longueur des pistes électriques et diminue la résistance des pistes.Réponse dynamique plus rapide : la régulation de puissance localisée réagit rapidement aux variations des besoins de traitement.Contrôle de tension plus précis : la régulation locale réduit le bruit électrique et prévient les pertes de tension.La réduction de la tension de fonctionnement de 1,2 V à 1,1 V permet de diminuer de 15 % la consommation d'énergie de la mémoire par rapport aux normes précédentes. Cette réduction de la consommation d'énergie minimise la production de chaleur dans les châssis d'entreprise haute densité. Le choix de mémoire vive DDR5 haute densité réduit les besoins en refroidissement dans les environnements rack denses. Cette gestion intelligente de l'énergie optimise le coût total de possession tout en maintenant des performances système optimales. La mémoire vive DDR5 haute densité offre une fiabilité et une efficacité énergétique exceptionnelles pour les serveurs d'entreprise exigeants. L'optimisation de l'approvisionnement en mémoire serveur repose sur l'équilibre entre les exigences de charge de travail, les objectifs de densité et les contraintes budgétaires. Le choix d'un module de mémoire serveur adapté garantit un fonctionnement optimal à long terme. Avant tout achat de matériel DDR5, il est impératif de consulter les listes de fournisseurs qualifiés pour les cartes mères. L'utilisation de mémoire non vérifiée peut entraîner des blocages à l'initialisation et des redémarrages système inopinés. Les tests effectués par les fournisseurs garantissent la stabilité des puces mémoire sous fortes charges de calcul. La mise à niveau planifiée de la mémoire vive des serveurs améliore les performances globales de traitement. Le déploiement de composants DDR5 1,1 V à faible consommation réduit la consommation d'énergie et la dissipation thermique dans les baies du centre de données. Une gestion stratégique des rangs optimise la bande passante sur les canaux actifs. Une planification rigoureuse de la mémoire DDR5 préserve la fiabilité de votre infrastructure lors des mises à niveau critiques des serveurs. Une planification intelligente des mises à niveau optimise votre coût total de possession sur le long terme. FAQPourquoi choisir de la mémoire vive DDR5 pour vos serveurs d'entreprise ?Les serveurs modernes nécessitent une puissance de traitement rapide pour les tâches de calcul intensives. Le déploiement de mémoire vive DDR5 augmente la bande passante totale du système. La technologie DDR5 de nouvelle génération améliore la fiabilité opérationnelle. Vous réduisez la consommation d'énergie globale grâce à un fonctionnement efficace sous 1,1 V.Comment une mise à niveau de la mémoire vive d'un serveur améliore-t-elle la bande passante du système ?La mise à niveau de la mémoire vive de votre serveur augmente le nombre de canaux de données actifs sur votre carte mère. Un module DDR5 haute performance de 64 Go transfère les données jusqu'à 5 600 MT/s. Cette vitesse élevée réduit la latence de la mémoire brute lors d'opérations parallèles intensives. Vous éliminez ainsi les goulots d'étranglement importants au sein de votre centre de données.Pourquoi les RDIMM sont-elles la meilleure mémoire RAM DDR5 pour les charges de travail critiques ?Les modules RDIMM mettent en mémoire tampon les signaux d'adresse et de commande afin de réduire la charge électrique sur les contrôleurs de mémoire. Le choix d'une mémoire DDR5 de qualité optimale garantit une intégrité du signal robuste, même avec des configurations multicanaux DIMM. Cette conception de mémoire serveur équilibrée permet une mise à niveau système fluide sans impact sur la fréquence du bus.En quoi les modules à double rang sont-ils avantageux pour les mises à niveau de serveur planifiées ?Les modules 2Rx4 double rangée offrent un équilibre optimal entre capacité et qualité du signal sur les pistes de la carte mère. Vous optimisez ainsi la densité par socket tout en maintenant un débit élevé de la mémoire DDR5 sur les canaux utilisés. Planifier des mises à niveau stratégiques de vos serveurs avec du matériel DDR5 sécurise votre infrastructure. Cette mise à niveau matérielle optimise le coût total de possession à long terme.
  • Contrôleur HBA ou contrôleur RAID : lequel est le meilleur pour le stockage moderne défini par logiciel ?
    Contrôleur HBA ou contrôleur RAID : lequel est le meilleur pour le stockage moderne défini par logiciel ?
    May 21, 2026
    Pour un stockage logiciel moderne défini par logiciel, privilégiez une carte HBA si la flexibilité et l'intégration avec des solutions RAID logicielles avancées sont primordiales. Une carte RAID offre des vitesses de lecture et d'écriture séquentielles plus élevées, une latence plus faible et des performances d'IOPS aléatoires supérieures, comme illustré ci-dessous :MétriquePerformances du contrôleur RAIDPerformances de la carte HBAVitesse de lecture séquentielleJusqu'à 12 Gb/sDépend du système hôteVitesse d'écriture séquentielleJusqu'à 10 Gb/sDépend du système hôteIOPS de lecture aléatoirePlus de 100 000Plus de 50 000IOPS d'écriture aléatoirePlus de 50 000Plus de 20 000LatenceLatence réduite grâce à la mise en cacheLatence plus élevéeAvant tout déploiement, il est essentiel d'évaluer les performances, le coût et la compatibilité. Ce blog vous propose des comparaisons claires et des conseils pratiques. Points clés à retenirChoisissez un contrôleur HBA pour plus de flexibilité et un accès direct aux lecteurs dans les environnements de stockage définis par logiciel.Les contrôleurs RAID offrent des performances supérieures et une protection des données optimale, ce qui les rend idéaux pour les applications critiques.Évaluez vos besoins en matière de charge de travail pour sélectionner le contrôleur approprié ; le HBA convient aux SDS modernes, tandis que le RAID est adapté aux configurations traditionnelles.Vérifiez toujours la compatibilité et la prise en charge du firmware avant de déployer des solutions HBA ou RAID afin de garantir des performances optimales.Lors du choix de solutions de stockage, tenez compte du coût total de possession, incluant la maintenance et la consommation d'énergie.Carte HBA vs carte RAID : principales différences Qu'est-ce qu'un HBA ?Vous utilisez une carte HBA (Host Bus Adapter) pour connecter votre serveur à plusieurs périphériques de stockage. Les cartes HBA fonctionnent comme des contrôleurs de transit, permettant à votre système d'exploitation d'accéder directement à chaque disque connecté. Cet accès direct est indispensable pour utiliser des solutions RAID logicielles telles que ZFS ou vSAN. Dans le stockage d'entreprise, les cartes HBA facilitent la gestion efficace d'un grand nombre de disques. On les trouve fréquemment dans les centres de données où la flexibilité et la compatibilité avec les solutions de stockage logiciel avancées sont primordiales. Qu'est-ce qu'une carte RAID ?Une carte RAID, également appelée contrôleur RAID, gère plusieurs disques et les combine en un seul disque virtuel. Dotée de son propre processeur et de sa propre mémoire cache, elle effectue tous les calculs RAID (striping, mirroring et parité) sans solliciter le processeur principal du serveur. Ce déchargement améliore les performances et réduit la latence. On utilise les cartes RAID lorsqu'une protection matérielle des données et des temps de reconstruction plus rapides sont nécessaires. Dans de nombreux environnements d'entreprise, elles simplifient la gestion du stockage et prennent en charge des fonctionnalités avancées comme le remplacement à chaud et le stockage hiérarchisé. Principales différencesLorsque vous comparez HBA et RAID, vous constatez plusieurs différences architecturales et opérationnelles :Les cartes HBA fonctionnent en mode pass-through, offrant à votre système d'exploitation un contrôle total sur chaque disque. Cette configuration est idéale pour le RAID logiciel.Les cartes RAID gèrent toute la logique RAID en interne. Elles présentent un seul volume logique à votre système, masquant ainsi les disques sous-jacents.Dans les centres de données, on utilise souvent un petit disque de démarrage et on laisse une carte HBA ou une carte RAID gérer le reste du stockage.Les deux contrôleurs prennent en charge les disques de grande capacité, mais vous devrez peut-être passer à des contrôleurs SAS ou SATA 6 Gb/s plus récents pour les disques de plus de 2,1 To.Conseil: Si vous avez besoin d'un échange à chaud ou d'un stockage hiérarchisé, les solutions de contrôleur RAID et HBA peuvent toutes deux prendre en charge ces fonctionnalités, selon votre matériel.FonctionnalitéDescriptionRemplacement à chaudPermet de remplacer les disques sans éteindre le système.Stockage à plusieurs niveauxCompatible avec les disques SAS, SATA et NVMe pour des configurations de stockage flexibles.Contrôleur uniqueIl combine plusieurs protocoles, réduisant ainsi la complexité et les coûts.Vous devez choisir entre les cartes RAID et les cartes HBA en fonction de vos besoins en matière de RAID matériel, de RAID logiciel ou de fonctionnalités de stockage avancées.Avantages et inconvénients Avantages et inconvénients de l'HBALorsque vous évaluez les cartes HBA pour le stockage défini par logiciel, vous constatez plusieurs avantages évidents :Vous bénéficiez d'une meilleure rentabilité, notamment grâce à l'utilisation de cartes HBA iSCSI sur des réseaux Ethernet standard. Cette approche évite le recours à du matériel spécialisé et coûteux.Vous bénéficiez ainsi de vitesses de transfert de données accrues. Les cartes HBA créent un chemin direct et efficace pour le flux d'informations, ce qui est essentiel pour les grands ensembles de données et les applications hautes performances.Vous bénéficiez d'une fiabilité et d'une stabilité accrues. Des fonctionnalités telles que le multipathing et le basculement automatique assurent la connectivité de votre stockage et réduisent les risques de corruption de données ou de pannes système. La correction d'erreurs avancée et une architecture robuste vous permettent de gérer des charges de travail importantes avec des performances constantes. Toutefois, il faut également tenir compte des limitations des cartes HBA dans les déploiements à grande échelle :LimitationDescriptionBande passante limitéeLes interconnexions plus anciennes (6–12 Gbps) tombent en panne sous des charges de travail importantes.Performances d'E/S limitéesLimité par l'inefficacité du protocole et un micrologiciel obsolète.Défis liés à l'évolutivitéIl est difficile d'étendre les baies de stockage sans interruption de service ni reconfiguration.Risques de compatibilitéLes cartes contrôleurs plus anciennes peuvent ne pas prendre en charge les protocoles de stockage modernes tels que NVMe ou Fibre Channel Gen7.Taux d'échec plus élevésL'absence de certification des fournisseurs entraîne une assistance incohérente aux pilotes et une augmentation des temps d'arrêt.Il convient de toujours vérifier la compatibilité et la prise en charge du micrologiciel avant de déployer des cartes HBA dans des environnements critiques. Avantages et inconvénients des cartes RAIDLes cartes RAID offrent plusieurs avantages clés en matière de protection des données et de performances dans les systèmes de stockage traditionnels :La redondance des données est assurée par la mise en miroir et la parité, ce qui permet de conserver vos données disponibles même en cas de panne d'un disque.Vous minimisez les temps d'arrêt car le meilleur contrôleur RAID peut reconstruire automatiquement les données après une panne de disque.Vous bénéficiez d'une meilleure fiabilité, car la défaillance d'un seul nœud n'entraîne pas l'arrêt de l'ensemble du système. Cette configuration garantit la cohérence des données et protège contre les pertes de données.Vous constatez des performances accrues pour les disques durs et les SSD. Les cartes RAID améliorent le débit en autorisant des opérations de lecture et d'écriture simultanées sur plusieurs disques.Vous bénéficiez d'une protection des données intégrée grâce à différents niveaux RAID, tels que RAID 1, RAID 5 et RAID 6.Les contrôleurs RAID gèrent les disques en exécutant des opérations complexes comme le striping de données, qui consiste à diviser les données en blocs et à les écrire simultanément sur plusieurs disques. Ce processus améliore les performances, notamment lorsqu'un contrôleur RAID est utilisé pour le stockage SSD. Malgré ces avantages, l'utilisation de cartes RAID dans des environnements de stockage définis par logiciel présente plusieurs défis :Une surcharge de performances peut survenir car le RAID logiciel s'appuie sur le processeur pour sa gestion, ce qui peut ralentir votre système.Vous pourriez constater un nombre limité de niveaux RAID, ce qui restreindra votre flexibilité.Des problèmes d'évolutivité peuvent survenir, car la modification d'une configuration RAID logicielle est complexe et risquée.La dépendance au système d'exploitation signifie que l'intégrité de votre baie RAID est directement liée au système d'exploitation, ce qui peut causer des problèmes en cas de défaillance de ce dernier.Des limitations de performances en charge élevée apparaissent dans les environnements à forte activité d'E/S, où le RAID logiciel peut ne pas correspondre aux solutions matérielles.Lorsqu'un contrôleur RAID est utilisé en mode JBOD, ZFS peut créer des vdevs multi-périphériques, mais le contrôleur gère toujours le stockage indépendamment. Cette configuration peut engendrer des problèmes de performances et d'intégrité des données en raison de conflits potentiels entre les opérations ZFS et la gestion du contrôleur. Tableau comparatif : HBA vs RAIDVous pouvez utiliser le tableau suivant pour comparer les solutions HBA et RAID pour votre environnement de stockage :Caractéristique/AspectCartes HBACartes RAIDCoûtPlus faible, notamment avec iSCSI et Ethernet standardUn niveau supérieur nécessite du matériel spécialiséPerformanceHaute performance avec accès direct, mais limitée par les interconnexions et le firmware.Supérieur pour les E/S séquentielles et aléatoires, notamment avec cache et SSDProtection des donnéesRepose sur un RAID logiciel (par exemple, ZFS, vSAN)Redondance intégrée (mise en miroir, parité, disque de secours à chaud)ÉvolutivitéDifficile dans les grands réseauxPlus facile avec des manettes avancéesCompatibilitéPeut ne pas prendre en charge les protocoles les plus récentsPrise en charge étendue, mais peut limiter les fonctionnalités SDS avancéesUtilisation du cacheAucun cache embarquéLa mémoire cache intégrée améliore les performances et réduit la latence.Mode JBODPrise en charge nativePris en charge, mais peut entrer en conflit avec certains systèmes de gestion de systèmes comme ZFS.Efficacité du RAID logicielÉlevée, surtout avec les processeurs modernes et ZFSPeut être limité par l'abstraction du contrôleurOptimisation SSDCela dépend du modèle HBALe meilleur contrôleur RAID pour SSD optimise les performances de votre SSDFiabilitéCorrection d'erreurs avancée, mais risque de défaillance plus élevé en l'absence de certification.Le meilleur contrôleur RAID offre une protection robuste et des reconstructions automatiques.Le choix entre les cartes HBA et RAID dépend de vos besoins en matière de performances, de protection des données et de compatibilité avec votre plateforme de stockage définie par logiciel. Les contrôleurs RAID haut de gamme offrent généralement des performances et une fiabilité supérieures pour les baies SSD et HDD, tandis que les cartes HBA offrent plus de flexibilité et permettent de réaliser des économies pour les solutions SDS modernes. Performances dans le stockage défini par logiciel Fiche de données de sécurité avec HBAL'utilisation d'un contrôleur HBA dans un environnement de stockage défini par logiciel offre une flexibilité maximale. Le contrôleur HBA agit comme un périphérique de transit, permettant au système d'exploitation ou au logiciel de stockage de gérer directement chaque disque. Cette configuration est particulièrement adaptée aux plateformes telles que vSAN et ZFS, où la redondance et la protection des données sont gérées par logiciel. Vous pouvez ainsi facilement faire évoluer votre stockage et vous adapter aux variations de la charge de travail. L'absence de logique RAID matérielle vous évite une surcharge supplémentaire, ce qui peut améliorer les performances en conditions réelles, notamment avec des baies SSD haut de gamme. Toutefois, vous devez vous assurer que vos ressources CPU et mémoire sont suffisantes, car les calculs RAID logiciels consomment des ressources système.FonctionnalitéJBOD (HBA)Contrôleur RAIDGestion des donnéesGéré par logiciel/système d'exploitationGéré par la logique RAID matérielleRedondanceGéré par logiciel (par exemple, vSAN, ZFS)Fonctions de redondance intégréesPerformanceFlexible, sans surcharge RAIDPeut offrir une faible latence grâce au cache matérielCas d'utilisationIdéal pour les solutions de stockage définies par logicielAdapté aux environnements nécessitant une logique RAID Carte RAID dans SDSLes contrôleurs RAID matériels offrent les avantages d'une performance et d'une fiabilité élevées. Fonctionnant comme de véritables mini-ordinateurs, ils exécutent un firmware spécialisé pour gérer les algorithmes RAID et mettre en mémoire tampon les E/S grâce à un cache intégré. Cette architecture réduit les interruptions du processeur et les changements de contexte, ce qui améliore les IOPS et diminue la latence. Les meilleurs résultats sont obtenus dans les environnements à forte charge de travail en lecture/écriture aléatoire, tels que les bases de données ou les applications d'IA. Le cache intégré, notamment lorsqu'il est alimenté par batterie, améliore la vitesse d'écriture et réduit le temps d'attente des applications. Les contrôleurs RAID prennent en charge plusieurs niveaux RAID et des fonctionnalités avancées comme la gestion des disques de secours à chaud, ce qui optimise la fiabilité et les performances des baies HDD et SSD. Les contrôleurs RAID matériels fonctionnent comme des mini-ordinateurs intégrés aux serveurs, exécutant un firmware spécialisé, gérant les algorithmes RAID et mettant en mémoire tampon les E/S avec un cache intégré, ce qui réduit les interruptions du processeur et les changements de contexte au niveau du système d'exploitation.Cette architecture améliore les IOPS et réduit la latence pour les charges de travail de lecture/écriture aléatoires, ce qui la rend idéale pour les applications critiques.Les contrôleurs RAID matériels d'entreprise prennent en charge plusieurs niveaux RAID (par exemple, 0, 1, 5, 6, 10) et des fonctionnalités avancées telles que la gestion des disques de secours à chaud et l'analyse prédictive des disques, améliorant ainsi la fiabilité et les performances.Le RAID logiciel est économique et flexible, ce qui le rend adapté aux environnements de développement, aux serveurs de fichiers à petite échelle et aux laboratoires domestiques où les cycles CPU sont abondants.Cependant, le RAID logiciel peut rencontrer des difficultés de performance dans les scénarios exigeants et convient mieux aux déploiements non critiques, sauf s'il est associé à des SSD haut de gamme et à une marge de puissance CPU suffisante. vSAN, ZFS et charges de travail d'IADes différences notables apparaissent lors du déploiement de charges de travail vSAN, ZFS ou IA. vSAN et ZFS privilégient l'accès direct aux disques, obtenu grâce à une carte HBA. Cette approche offre une grande flexibilité et permet d'utiliser des fonctionnalités logicielles avancées pour la protection et la restauration des données. Pour les charges de travail IA, il est souvent essentiel de minimiser la latence et d'optimiser les IOPS. Les contrôleurs RAID avec cache dédié et logique RAID offrent des performances supérieures dans ces cas, notamment avec le stockage SSD. Le choix du contrôleur doit être adapté aux exigences de votre charge de travail. Si vous privilégiez la flexibilité et les fonctionnalités de stockage défini par logiciel, optez pour une carte HBA. En revanche, si vous avez besoin de performances et d'une fiabilité maximales pour des charges de travail critiques d'IA ou de bases de données, un contrôleur RAID compatible SSD est la solution idéale. Protection des données et redondanceRAID et protection des donnéesVous comptez sur le RAID pour une protection robuste des données dans le stockage d'entreprise. Les niveaux RAID 5, 6 et 10 offrent différents compromis entre performances, redondance et capacité. Le RAID 5 offre un bon équilibre entre vitesse et tolérance aux pannes, ce qui en fait un choix courant pour les serveurs. Le RAID 6 renforce la protection des données grâce à la double parité : vous pouvez ainsi perdre deux disques sans perte de données. Le RAID 10 combine la mise en miroir et le striping, offrant ainsi des performances et une redondance élevées, mais nécessitant davantage de disques et engendrant des coûts plus importants. L'utilisation de configurations RAID avec redondance réduit considérablement le risque de perte de données. Cependant, le RAID ne protège pas contre les suppressions accidentelles ni les cyberattaques. Il est donc indispensable de toujours conserver des sauvegardes externes pour garantir une protection complète des données. RAID 5 : Offre un équilibre entre performances, redondance et capacité.RAID 6 : Offre une tolérance aux pannes améliorée grâce à une double parité.RAID 10 : Offre des performances et une redondance élevées, mais à un coût plus élevé.Les niveaux RAID redondants réduisent le risque de perte de données.Le RAID ne peut pas empêcher la perte de données due à une suppression accidentelle ou à des cybermenaces. RAID logiciel avec HBAVous pouvez obtenir une protection des données flexible en associant un RAID logiciel à un contrôleur HBA. Ce dernier agit comme un relais, permettant à votre logiciel de gérer directement chaque disque. Cette configuration est idéale pour les plateformes telles que ZFS ou Ceph, qui nécessitent des fonctionnalités avancées d'intégrité des données. Les cartes HBA modernes, compatibles SAS-4, tri-mode et intégrant PCIe 5.0, optimisent les performances et la fiabilité. Vous bénéficiez ainsi d'une augmentation des IOPS jusqu'à 50 % et d'une consommation d'énergie réduite, contribuant aux initiatives de centres de données écologiques. Le firmware en mode IT des cartes HBA réduit les goulots d'étranglement, améliorant ainsi les performances du stockage défini par logiciel. Les cartes HBA Fibre Channel offrent une latence ultra-faible, essentielle pour les clusters à haute disponibilité. Le choix du contrôleur RAID ou du contrôleur HBA le plus adapté à votre charge de travail et à vos besoins en matière de protection des données est crucial. Fiabilité des SDSLors du déploiement d'un stockage défini par logiciel, la fiabilité doit être une priorité. Les cartes SAS HBA dominent la plupart des déploiements grâce à leurs performances constantes et à leur intégrité des données renforcée. Les cartes HBA tri-mode prennent en charge NVMe over Fabrics, ce qui augmente les IOPS et améliore la fiabilité. Il est recommandé d'utiliser le firmware en mode IT pour éviter les goulots d'étranglement du contrôleur RAID et optimiser l'intégrité des données. Les nouveaux modèles de cartes HBA consomment moins d'énergie, contribuant ainsi à atteindre vos objectifs opérationnels et environnementaux. Un contrôleur RAID performant assure la reconstruction automatique et la correction d'erreurs avancée, garantissant ainsi la sécurité de vos données. Les cartes RAID avec cache protégé par batterie protègent vos données en cas de coupure de courant, offrant une couche de sécurité supplémentaire. Pour une fiabilité et des performances optimales, il est essentiel d'adapter votre matériel à votre plateforme de stockage défini par logiciel.Conseil : Associez toujours le RAID à des sauvegardes régulières pour garantir une protection et une intégrité complètes des données, même en cas de pannes inattendues.Considérations relatives au déploiement Compatibilité serveurAvant de déployer une solution de stockage, il est essentiel de vérifier la compatibilité du serveur. Les grandes marques comme Dell, HPE, Lenovo et Supermicro proposent des serveurs compatibles avec les contrôleurs HBA et RAID. Il convient de vérifier la version du firmware et le type d'interface. De nombreux serveurs d'entreprise prennent en charge les disques SAS, SATA et NVMe. Si vous prévoyez d'utiliser un SSD ou un NVMe, choisissez un contrôleur RAID adapté à votre matériel. Assurez-vous que votre contrôleur prend en charge les protocoles les plus récents et offre des performances optimales. Certains serveurs nécessitent des contrôleurs propriétaires ; consultez donc la documentation du fournisseur. La compatibilité a un impact direct sur les performances, l'intégrité des données et la fiabilité. Quand éviter une carte RAIDIl est déconseillé d'utiliser une carte RAID dans certains environnements de stockage définis par logiciel. Si vous déployez ZFS, vSAN ou Ceph, vous devez accéder directement à chaque disque. Un contrôleur RAID peut interférer avec la logique RAID logicielle et réduire les performances. Des conflits entre la gestion matérielle et logicielle peuvent survenir, compromettant ainsi l'intégrité des données. Pour les charges de travail exigeantes utilisant des baies SSD, le RAID logiciel avec un HBA offre souvent une meilleure flexibilité. Il est également préférable d'éviter les cartes RAID si vous souhaitez bénéficier de fonctionnalités avancées telles que les snapshots ou le provisionnement fin. Dans les déploiements cloud-native, le RAID logiciel facilite l'évolutivité et l'intégration.Conseil : Vérifiez toujours si votre plateforme SDS recommande le mode JBOD ou l’accès direct au lecteur. Cela garantit des performances optimales et l’intégrité des données. Scénarios pratiquesVous pouvez optimiser votre déploiement de stockage en adaptant le contrôleur à votre charge de travail. Pour les serveurs de bases de données nécessitant un nombre élevé d'IOPS aléatoires, un contrôleur RAID avec cache améliore les performances. Si vous exécutez des charges de travail d'IA, choisissez un contrôleur compatible SSD et NVMe pour une faible latence. Pour les serveurs de sauvegarde ou le stockage de fichiers, le RAID logiciel avec HBA offre des économies et une grande flexibilité. Il est recommandé d'utiliser un RAID matériel pour les applications critiques où toute interruption de service est inacceptable. Pour les environnements de développement ou les laboratoires personnels, le RAID logiciel offre un meilleur contrôle et une extension plus facile. Lors du choix entre contrôleurs HBA et RAID, il est essentiel de trouver un équilibre entre performances, fiabilité et intégrité des données.ScénarioSolution recommandéeRaisonServeur de base de donnéesContrôleur RAIDHaute performance, redondanceCharge de travail IAContrôleur RAID pour NVMe/SSDFaible latence, IOPS maximalesSauvegarde/Stockage de fichiersHBA + RAID logicielRentable et flexibleEnvironnement de laboratoire/développement personnelHBA + RAID logicielExtension et contrôle facilesSDS natif du cloudHBA + RAID logicielÉvolutivité, intégrationConseils en matière de coûts et d'approvisionnement Coût total de possessionLors de l'évaluation des solutions de stockage, il est essentiel de prendre en compte d'autres facteurs que le simple prix du matériel. Le coût total de possession (CTP) inclut les supports de stockage, la conception du contrôleur, les licences, la maintenance, la consommation d'énergie, le refroidissement et les extensions futures. Les adaptateurs HBA et RAID Smart Storage offrent un micrologiciel et un logiciel unifiés, simplifiant ainsi la gestion et réduisant les coûts d'exploitation. Vous bénéficiez ainsi d'une amélioration des performances et d'économies d'énergie pouvant atteindre 40 %. La mise en œuvre et la gestion des adaptateurs HBA rationalisent les processus et optimisent l'utilisation des ressources. Cette approche permet de réduire le CTP, notamment dans les environnements où la flexibilité est primordiale.Un firmware unifié réduit la complexité.Les économies d'énergie réduisent les dépenses d'exploitation.Une gestion simplifiée réduit les coûts de maintenance.Une utilisation efficace des ressources améliore le retour sur investissement. Évolutivité dans SDSLors du déploiement d'un stockage défini par logiciel, la scalabilité est un critère essentiel. Les HBA facilitent l'extension et l'intégration avec des plateformes comme ZFS et Ceph. L'ajout de disques ou de nœuds s'effectue sans reconfiguration majeure. Cette flexibilité favorise une croissance rapide dans les environnements d'entreprise et cloud. Les contrôleurs RAID offrent des performances robustes pour les charges de travail traditionnelles, mais peuvent présenter des limitations liées à la dépendance vis-à-vis du fournisseur et aux défaillances du cache. En optant pour des HBA pour les déploiements SDS modernes, vous évitez ces risques. Les meilleurs contrôleurs RAID prennent en charge les baies de grande capacité et les fonctionnalités avancées, mais il est important de comparer la scalabilité aux coûts à long terme. Recommandations d'expertsLe choix de votre contrôleur doit être adapté à votre charge de travail et à vos objectifs de déploiement. Les experts recommandent les HBA pour les environnements de stockage définis par logiciel tels que ZFS et Ceph. Les contrôleurs RAID conviennent aux charges de travail d'entreprise traditionnelles et aux applications critiques. Dans les datacenters modernes, il est préférable d'éviter les cartes RAID afin de prévenir la dépendance vis-à-vis d'un fournisseur et les défaillances du cache. Un contrôleur RAID performant offre une fiabilité élevée pour les serveurs VMware et de bases de données. L'utilisation de HBA permet une intégration fluide avec les charges de travail d'IA, notamment dans les clusters vSAN et ZFS. Cette approche permet de réaliser des économies de 20 à 30 % sur le coût total de possession grâce à la flexibilité des JBOD.Type de contrôleurCacheBBU/SupercapCas d'utilisation optimalNiveau de risqueRAID matériel d'entrée de gammePetitFacultatifLaboratoires, sauvegardesMoyenEntreprise de taille moyenneMoyenOuiServeurs, RAID 10FaibleEntreprise haut de gammeGrandOuiVMware, bases de donnéesTrès basHBAAucunN / AZFS, CephCela dépendConseil : Évaluez toujours vos plans de croissance futurs et vos besoins en charge de travail avant de choisir le contrôleur RAID ou le HBA le mieux adapté à votre environnement.  Pour tirer pleinement parti du stockage défini par logiciel, choisissez un contrôleur HBA qui offre flexibilité et gestion directe des disques. La protection des données demeure essentielle dans chaque déploiement. Pour des résultats optimaux, suivez ces étapes :Vérifiez la compatibilité des emplacements pour éviter les problèmes de bande passante.Choisissez le nombre de ports approprié pour la protection et la redondance des données.Vérifiez la compatibilité des pilotes et du système d'exploitation pour une protection stable des données.Déterminez si vous avez besoin d'un transfert direct ou d'une gestion de disque pour une protection optimale des données.Les plateformes SDS gèrent la protection des données au niveau logiciel.En mode IT, le HBA ou le RAID prend en charge la protection transparente des données.Le RAID matériel peut limiter la protection des données dans un SDS.Évaluez vos besoins afin de garantir un juste équilibre entre performance et protection des données.FAQQuel est le principal avantage de l'utilisation d'un HBA dans un stockage défini par logiciel ?Vous bénéficiez d'un accès direct au lecteur grâce à un contrôleur HBA. Cette configuration permet à votre logiciel de gérer la redondance et la protection des données. Vous profitez ainsi d'une plus grande flexibilité et d'une intégration simplifiée avec des plateformes telles que ZFS et vSAN.Est-il possible de combiner des contrôleurs HBA et RAID dans un même serveur ?Vous pouvez les utiliser ensemble, mais cela nécessite une planification minutieuse. Mélanger les contrôleurs peut entraîner des problèmes de compatibilité ou compliquer la gestion. Consultez toujours les recommandations de votre plateforme SDS avant de les combiner.Le RAID logiciel avec HBA a-t-il un impact sur les performances du processeur ?Oui, le RAID logiciel utilise le processeur de votre serveur pour les calculs RAID. Assurez-vous que votre système dispose d'une puissance de traitement suffisante pour gérer à la fois les tâches de stockage et les charges de travail applicatives.Quel contrôleur choisir pour les disques NVMe ?Vous devriez choisir un contrôleur HBA ou RAID compatible NVMe. De nombreux contrôleurs HBA modernes offrent une prise en charge tri-mode SAS, SATA et NVMe, vous offrant ainsi une flexibilité optimale pour le stockage haute vitesse.

laisser un message

laisser un message
Si nos produits vous intéressent et que vous souhaitez en savoir plus, veuillez Laissez un message ici, nous vous répondrons dès que possible.

Maison

Produits

Contactez-nous

laisser un message
Si nos produits vous intéressent et que vous souhaitez en savoir plus, veuillez Laissez un message ici, nous vous répondrons dès que possible.